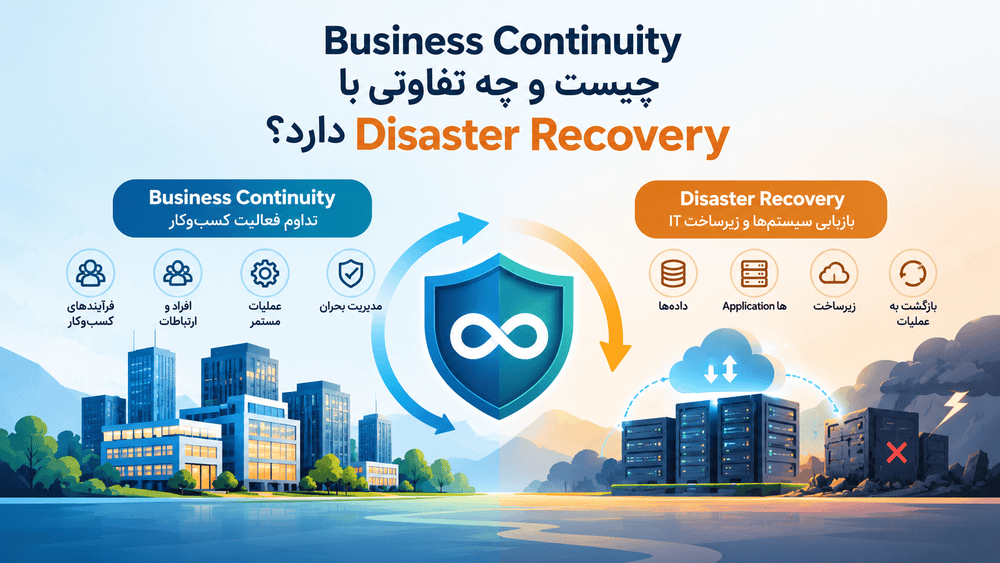
اگر یک سرور از کار بیفتد، معمولاً میتوان آن را دوباره راهاندازی کرد. اگر یک Database خراب شود، میتوان از Backup استفاده کرد. اما اگر یک سازمان برای چند ساعت یا چند روز نتواند خدمات اصلی خود را ارائه کند، مسئله دیگر فقط «خرابی سرور» نیست؛ بلکه تداوم فعالیت کسبوکار (Business Continuity) مطرح است.
Business Continuity یا BC مجموعهای از سیاستها، فرآیندها و برنامههایی است که به سازمان کمک میکند فعالیتهای حیاتی خود را هنگام وقوع یک بحران حفظ کند یا در سریعترین زمان ممکن به وضعیت عملیاتی بازگرداند.
در مقابل، Disaster Recovery یا DR بیشتر روی بازیابی زیرساخت، سیستمهای IT، Applicationها، Databaseها و دادهها پس از یک اختلال یا Disaster تمرکز دارد.
بنابراین این دو مفهوم بسیار به یکدیگر مرتبط هستند، اما یکسان نیستند. در واقع میتوان گفت Disaster Recovery یکی از اجزای مهم Business Continuity است.
Business Continuity چیست؟
Business Continuity یا تداوم کسبوکار، رویکردی برای اطمینان از این است که سازمان بتواند در زمان وقوع اختلالهای جدی، فعالیتهای حیاتی خود را ادامه دهد یا با حداقل وقفه دوباره فعال کند.
این اختلال میتواند ناشی از عوامل مختلفی باشد:
- قطعی یا اختلال گسترده اینترنت
- خرابی Data Center
- حمله سایبری
- Ransomware
- خرابی تجهیزات شبکه
- قطع برق
- آتشسوزی یا حادثه فیزیکی
- از دست رفتن Database
- اختلال در سرویسدهندگان Third-party
- اختلال در زنجیره تأمین
- خطای انسانی
- از دسترس خارج شدن نیروی انسانی کلیدی
نکته مهم این است که Business Continuity فقط مربوط به IT نیست.
برای مثال اگر یک شرکت فروش آنلاین با قطعی کامل سیستم سفارشگیری مواجه شود، Business Continuity باید مشخص کند:
- آیا سفارشها همچنان قابل دریافت هستند؟
- کارکنان چگونه فعالیت میکنند؟
- مشتریان چگونه اطلاعرسانی میشوند؟
- پرداختها چگونه مدیریت میشوند؟
- زنجیره تأمین چگونه ادامه پیدا میکند؟
- در صورت نبود سیستم اصلی، فرآیند جایگزین چیست؟
بنابراین BC یک نگاه Business-oriented دارد، نه صرفاً Infrastructure-oriented.
Disaster Recovery چیست؟
Disaster Recovery یا بازیابی پس از بحران، مجموعهای از فرآیندها و زیرساختهایی است که برای بازگرداندن سیستمها، Applicationها، دادهها و سرویسهای IT پس از یک حادثه طراحی میشوند.
برای مثال فرض کنید Data Center اصلی یک سازمان به دلیل قطعی برق یا حادثه فیزیکی از دسترس خارج شده است.
یک برنامه DR ممکن است شامل موارد زیر باشد:
- Backup از Databaseها
- Replication دادهها به سایت دوم
- Backup از Object Storage
- Standby Kubernetes Cluster
- Backup از Configurationها
- DNS Failover
- Recovery Serverها
- Restore کردن Applicationها
- تغییر مسیر Traffic به سایت جایگزین
هدف DR این است که زیرساخت IT بتواند در زمان مشخصی دوباره عملیاتی شود.
برای مطالعه عمیقتر این موضوع میتوانید مقاله Disaster Recovery چیست؟ را نیز مطالعه کنید.
تفاوت Business Continuity و Disaster Recovery در یک نگاه
| موضوع | Business Continuity | Disaster Recovery |
|---|---|---|
| تمرکز اصلی | تداوم فعالیت کسبوکار | بازیابی سیستمها و زیرساخت IT |
| دامنه | کل سازمان | عمدتاً IT و Technology |
| هدف | حفظ یا ادامه فعالیتهای حیاتی | بازگرداندن سرویسها و دادهها |
| دیدگاه | Business-oriented | Technology-oriented |
| شامل فرآیندهای غیر IT؟ | بله | معمولاً خیر یا بهصورت محدود |
| Backup | یکی از اجزا | یکی از اجزای اصلی |
| Failover | ممکن است بخشی از برنامه باشد | یکی از مکانیزمهای اصلی |
| ارتباط | چارچوب بزرگتر | یکی از اجزای BC |
یک مثال ساده برای درک تفاوت BC و DR
فرض کنید یک فروشگاه اینترنتی به دلیل خرابی Data Center اصلی، برای چند ساعت به سرویسهای خود دسترسی ندارد.
Disaster Recovery میپرسد:
- چگونه Database را Restore کنیم؟
- چگونه Application را روی زیرساخت جایگزین اجرا کنیم؟
- چگونه Kubernetes Cluster دوم را فعال کنیم؟
- چگونه Traffic را به سایت دوم منتقل کنیم؟
اما Business Continuity سؤالات بزرگتری مطرح میکند:
- در این مدت سفارش مشتریان چگونه ثبت شود؟
- پشتیبانی مشتریان چگونه فعالیت کند؟
- پرداختها چگونه مدیریت شوند؟
- مشتریان چگونه از وضعیت سرویس مطلع شوند؟
- کارکنان در صورت از دسترس خارج شدن دفتر اصلی چگونه کار کنند؟
- کدام فعالیتها باید در اولویت بازگردانی قرار بگیرند؟
به همین دلیل DR را میتوان یکی از ابزارهای اجرای Business Continuity دانست.
Business Continuity Plan یا BCP چیست؟
Business Continuity Plan یا BCP سند و مجموعه رویههایی است که مشخص میکند سازمان در زمان وقوع یک بحران چگونه فعالیتهای حیاتی خود را ادامه خواهد داد.
یک BCP مناسب باید فقط یک فایل روی سرور یا یک سند PDF بایگانیشده نباشد. افراد مسئول باید آن را بشناسند و فرآیندهای تعریفشده باید بهصورت دورهای تمرین و آزمایش شوند.
یک BCP میتواند شامل موارد زیر باشد:
- Business Impact Analysis
- Risk Assessment
- Critical Business Processes
- Recovery Priorities
- Communication Plan
- Alternative Work Locations
- Alternative Suppliers
- IT Disaster Recovery
- Incident Management
- Emergency Contacts
- Testing and Exercise Plan
Business Impact Analysis یا BIA چیست؟
یکی از مهمترین مراحل طراحی Business Continuity، انجام Business Impact Analysis یا BIA است.
در BIA مشخص میشود که از دست رفتن هر سرویس یا فرآیند چه تأثیری بر کسبوکار خواهد داشت.
برای مثال:
| سرویس | اهمیت | اثر قطعی | اولویت Recovery |
|---|---|---|---|
| سیستم پرداخت | بحرانی | توقف درآمد | بسیار بالا |
| سیستم سفارش | بحرانی | عدم ثبت سفارش | بسیار بالا |
| CRM | بالا | اختلال در عملیات فروش | بالا |
| داشبورد داخلی | متوسط | کاهش Visibility | متوسط |
| سیستم گزارشگیری تاریخی | پایین | تأخیر در گزارشها | پایین |
این تحلیل کمک میکند سازمان منابع محدود خود را برای سرویسهایی که بیشترین اهمیت را دارند اختصاص دهد.
RTO چیست؟
RTO یا Recovery Time Objective حداکثر زمان قابل قبول برای بازگرداندن یک سرویس پس از اختلال است.
برای مثال اگر RTO یک سرویس ۳۰ دقیقه باشد، برنامه Recovery باید بتواند سرویس را حداکثر در حدود ۳۰ دقیقه به وضعیت عملیاتی برگرداند.
RTO پایینتر معمولاً به زیرساخت، Automation و آمادگی بیشتری نیاز دارد.
RPO چیست؟
RPO یا Recovery Point Objective مشخص میکند سازمان حداکثر چه میزان از دادههای جدید را در صورت وقوع حادثه میتواند از دست بدهد.
برای مثال:
- RPO = 24 ساعت → احتمال از دست رفتن دادههای یک روز وجود دارد.
- RPO = 1 ساعت → حداکثر یک ساعت داده باید قابل بازیابی باشد.
- RPO = چند دقیقه → نیازمند Backup یا Replication بسیار نزدیک به Real-time است.
- RPO نزدیک به صفر → معمولاً نیازمند معماریهای Replication بسیار پیشرفته است.
RPO و RTO باید برای هر سرویس بر اساس اهمیت واقعی آن تعیین شوند، نه اینکه برای همه سیستمها یک مقدار ثابت در نظر گرفته شود.
تفاوت RPO و RTO
| مفهوم | سؤال | مثال |
|---|---|---|
| RPO | چه مقدار Data Loss قابل قبول است؟ | حداکثر ۱ ساعت |
| RTO | سرویس چه مدت میتواند Down باشد؟ | حداکثر ۳۰ دقیقه |
برای مثال ممکن است یک سرویس RPO برابر یک ساعت و RTO برابر ۳۰ دقیقه داشته باشد. یعنی در زمان Disaster باید سرویس حداکثر طی ۳۰ دقیقه برگردد و دادههای بیش از یک ساعت قبل از حادثه نباید از دست بروند.
Business Continuity چه ارتباطی با Disaster Recovery دارد؟
میتوان این رابطه را به شکل زیر تصور کرد:
                    Business Continuity
                           │
        ┌──────────────────┼──────────────────┐
        ▼                  ▼                  ▼
   Business Plans     Crisis Management    IT Continuity
                                                │
                                                ▼
                                       Disaster Recovery
                                                │
                              ┌─────────────────┼─────────────────┐
                              ▼                 ▼                 ▼
                           Backup          Replication        Failover
در این مدل، Disaster Recovery بخشی از برنامه گستردهتر Business Continuity است.
Business Continuity و Incident Response چه تفاوتی دارند؟
Incident Response بیشتر به نحوه شناسایی، کنترل و پاسخ به یک Incident میپردازد.
برای مثال در یک حمله سایبری:
- تشخیص حمله
- Containment
- تحلیل Incident
- حذف عامل تهدید
- جمعآوری شواهد
- بازگرداندن سیستم
میتوانند بخشی از فرآیند Incident Response باشند.
اما Business Continuity سؤال دیگری دارد: در زمان وقوع این Incident، چگونه فعالیت حیاتی کسبوکار ادامه پیدا کند؟
در سازمانهای بالغ، Incident Response، Disaster Recovery و Business Continuity در کنار یکدیگر طراحی میشوند.
چه نوع بحرانهایی باید در BCP در نظر گرفته شوند؟
برنامه Business Continuity نباید فقط برای یک سناریوی خاص مانند خرابی Server نوشته شود.
برخی سناریوهای مهم عبارتاند از:
خرابی زیرساخت IT
مانند خرابی Storage، Server، Network یا Data Center.
حمله سایبری
مانند Ransomware، Data Breach یا Compromise شدن حسابهای مدیریتی.
اختلال سرویسدهنده
مانند از دسترس خارج شدن Cloud Provider، ISP، DNS Provider یا Payment Provider.
قطع برق
بهخصوص برای سازمانهایی که زیرساخت On-Premise دارند.
بحران فیزیکی
مانند آتشسوزی، سیل یا حادثهای که دسترسی به ساختمان یا Data Center را غیرممکن کند.
از دسترس خارج شدن نیروی انسانی
Business Continuity باید وابستگی به افراد کلیدی را نیز بررسی کند.
Business Continuity در زیرساخت IT
از دید زیرساخت، چندین تکنیک میتوانند به افزایش تداوم سرویس کمک کنند:
- High Availability
- Clustered Infrastructure
- Load Balancing
- Database Replication
- Backup
- Disaster Recovery Site
- Multi-Data Center Architecture
- Infrastructure as Code
- Automated Deployment
- Centralized Monitoring
اما هرکدام باید براساس RTO، RPO و اهمیت Business انتخاب شوند.
برای مثال، اگر RTO یک Application چند روز باشد، شاید داشتن یک Active-Active Multi-Data Center معماری بیشازحد پیچیدهای باشد.
در مقابل، برای یک سرویس حیاتی که حتی چند دقیقه Downtime نیز قابل قبول نیست، Backup ساده ممکن است کافی نباشد.
Backup چه نقشی در Business Continuity دارد؟
Backup یکی از اجزای مهم Resilience و Disaster Recovery است، اما Backup بهتنهایی Business Continuity نیست.
ممکن است سازمان Backup سالمی داشته باشد، اما اگر:
- Backup قابل Restore نباشد،
- فرآیند Restore مستند نشده باشد،
- افراد مسئول مشخص نباشند،
- Infrastructure کافی برای Recovery وجود نداشته باشد،
- DNS و Network آماده نباشند،
- Database Dependencyها مشخص نشده باشند،
در زمان بحران Recovery بسیار دشوارتر از چیزی خواهد بود که روی کاغذ تصور شده است.
برای همین، Restore Test یکی از مهمترین قسمتهای برنامه DR است.
برای آشنایی بیشتر با رویکردهای Backup میتوانید مقاله قانون Backup 3-2-1 چیست؟ را مطالعه کنید.
High Availability، Disaster Recovery و Business Continuity
این سه مفهوم نیز گاهی با یکدیگر اشتباه گرفته میشوند.
| مفهوم | تمرکز | نمونه |
|---|---|---|
| High Availability | کاهش Downtime هنگام Failure | Cluster و Failover |
| Disaster Recovery | بازیابی پس از Disaster | DR Site و Backup |
| Business Continuity | ادامه فعالیت کسبوکار | BCP و فرآیندهای جایگزین |
برای مثال Load Balancer و دو Server میتوانند Availability یک Application را افزایش دهند، اما اگر Data Center کاملاً از بین برود، این معماری بهتنهایی DR محسوب نمیشود.
همچنین داشتن DR Site بهتنهایی تضمین نمیکند که کل کسبوکار بتواند در زمان بحران فعالیت کند.
Business Continuity در معماری Kubernetes
در محیطهای Cloud Native و Kubernetes نیز Business Continuity باید فراتر از خود Cluster طراحی شود.
یک معماری ممکن است شامل موارد زیر باشد:
                 Global Traffic
                       │
              ┌────────┴────────┐
              ▼                 ▼
       Kubernetes DC1     Kubernetes DC2
              │                 │
          Application       Application
              │                 │
              └────────┬────────┘
                       ▼
               Replicated Data
در این معماری، فقط Application نباید در سایت دوم وجود داشته باشد. مواردی مانند Database، Object Storage، Secrets، Configuration، DNS و فرآیند Deployment نیز باید در برنامه Recovery لحاظ شوند.
برای طراحی زیرساختهای Kubernetes میتوانید مقاله مقدمهای بر Kubernetes را نیز مطالعه کنید.
Business Continuity و Multi-Cluster
استفاده از چند Kubernetes Cluster میتواند بخشی از استراتژی Resilience باشد، اما Multi-Cluster بهتنهایی Business Continuity ایجاد نمیکند.
برای مثال:
Primary Cluster
      │
      │ Application / Data Replication
      ▼
Secondary Cluster
      │
      ▼
Recovery Process
باید مشخص شود در زمان Failure چه کسی تصمیم به Failover میگیرد، چگونه Traffic منتقل میشود، Database چگونه Recovery میشود و چه زمانی سیستم به حالت Normal بازمیگردد.
برای آشنایی بیشتر با معماری Multi-Cluster، مقاله مدیریت چندکلاستری در Kubernetes را مطالعه کنید.
Business Continuity و Observability
برای اینکه بدانیم یک سرویس واقعاً آماده Recovery است، باید بتوانیم وضعیت آن را مشاهده کنیم.
Monitoring و Observability میتوانند اطلاعاتی مانند موارد زیر را فراهم کنند:
- Availability
- Latency
- Error Rate
- Resource Usage
- Database Health
- Replication Status
- Backup Status
- Application Errors
- Infrastructure Failures
بدون Visibility مناسب، ممکن است سازمان زمانی متوجه شکست Backup یا Replication شود که دیگر برای Recovery دیر شده باشد.
به همین دلیل Monitoring و Log Management باید بخشی از معماری Resilience باشند.
چگونه یک برنامه Business Continuity طراحی کنیم؟
مرحله اول: شناسایی سرویسهای حیاتی
ابتدا باید مشخص شود کدام Business Processها برای سازمان حیاتی هستند.
مرحله دوم: انجام Business Impact Analysis
تأثیر توقف هر سرویس و اولویت Recovery مشخص میشود.
مرحله سوم: شناسایی Riskها
سناریوهای مختلفی که میتوانند باعث اختلال شوند شناسایی و تحلیل میشوند.
مرحله چهارم: تعیین RTO و RPO
برای هر سرویس باید Recovery Objective مشخص شود.
مرحله پنجم: طراحی Strategy
براساس نیاز میتوان از Backup، Replication، HA، DR Site، Multi-DC یا روشهای دیگر استفاده کرد.
مرحله ششم: مستندسازی
فرآیندهای Recovery، مسئولیت افراد، شمارههای تماس، دسترسیها و مراحل اجرایی باید مستند شوند.
مرحله هفتم: Automation
هرجا امکان دارد Recovery و Deployment باید Automation شوند تا وابستگی به عملیات دستی کاهش پیدا کند.
استفاده از Infrastructure as Code میتواند در این بخش بسیار مفید باشد.
مرحله هشتم: تست
برنامهای که تست نشده است، صرفاً یک فرضیه است.
باید سناریوهای مختلف مانند Restore Backup، Failover و از دست رفتن سرویسهای وابسته آزمایش شوند.
انواع تست Business Continuity و Disaster Recovery
تستها میتوانند از نظر میزان درگیری سازمان متفاوت باشند.
- Tabletop Exercise: بررسی سناریو بهصورت جلسه و شبیهسازی تصمیمگیری
- Technical Test: آزمایش بخش فنی Recovery
- Restore Test: بازیابی واقعی Backup
- Failover Test: انتقال سرویس به زیرساخت جایگزین
- Full Simulation: شبیهسازی گسترده یک بحران
هدف تست فقط اطمینان از کار کردن یک Server نیست؛ بلکه باید مشخص شود کل فرآیند Recovery تا رسیدن به وضعیت عملیاتی قابل اجرا است.
اشتباهات رایج در Business Continuity
اشتباه اول: تصور اینکه Backup کافی است
Backup فقط یکی از اجزای Recovery است.
اشتباه دوم: مشخص نکردن RTO و RPO
بدون Objective مشخص، نمیتوان تشخیص داد که معماری Recovery واقعاً نیاز کسبوکار را برآورده میکند یا خیر.
اشتباه سوم: تست نکردن Recovery
ممکن است Backup خراب، ناقص یا غیرقابل Restore باشد.
اشتباه چهارم: وابستگی بیشازحد به افراد
اگر فقط یک نفر بداند چگونه سیستم را Recovery کند، سازمان همچنان یک Single Point of Failure انسانی دارد.
اشتباه پنجم: تمرکز صرف بر IT
Business Continuity باید فرآیندهای کسبوکار، ارتباط با مشتری، کارکنان، تأمینکنندگان و سایر وابستگیها را نیز در نظر بگیرد.
اشتباه ششم: طراحی بیشازحد پیچیده
Active-Active Multi-Data Center، Multi-Cluster و Replication پیشرفته همیشه بهترین پاسخ نیستند. معماری باید متناسب با RTO، RPO، هزینه و اهمیت سرویس طراحی شود.
چکلیست Business Continuity
| حوزه | وضعیت مورد بررسی |
|---|---|
| Business Impact Analysis | سرویسهای حیاتی شناسایی شدهاند؟ |
| Risk Assessment | سناریوهای اصلی بحران مشخص شدهاند؟ |
| RTO | زمان قابل قبول Recovery مشخص است؟ |
| RPO | میزان Data Loss قابل قبول مشخص است؟ |
| Backup | Backup منظم و قابل بازیابی است؟ |
| Restore | Restore واقعی تست شده است؟ |
| DR | زیرساخت جایگزین وجود دارد؟ |
| Security | سناریوی Cyber Attack در نظر گرفته شده است؟ |
| Communication | روش اطلاعرسانی در زمان بحران مشخص است؟ |
| Responsibility | مسئول هر مرحله مشخص است؟ |
| Documentation | Runbookهای Recovery مستند هستند؟ |
| Testing | برنامه Recovery بهصورت دورهای تست میشود؟ |
Business Continuity، DR و Resilience
در معماریهای مدرن، بهتر است Business Continuity را بخشی از یک نگاه بزرگتر به Resilience سازمان بدانیم.
Resilience به توانایی سازمان و سیستم برای تحمل اختلال، ادامه فعالیت و بازگشت به وضعیت پایدار اشاره دارد.
در لایه Technology، موارد زیر میتوانند در این هدف نقش داشته باشند:
- High Availability
- Disaster Recovery
- Backup
- Monitoring
- Security
- Automation
- Infrastructure as Code
- Multi-Data Center
- Business Continuity Planning
این اجزا زمانی بیشترین ارزش را دارند که بهصورت یک معماری یکپارچه طراحی شوند، نه بهعنوان مجموعهای از ابزارهای مستقل.
جمعبندی
Business Continuity به این سؤال پاسخ میدهد که سازمان چگونه میتواند در زمان وقوع بحران، فعالیتهای حیاتی خود را ادامه دهد یا با حداقل وقفه به فعالیت بازگردد.
Disaster Recovery بخش مهمی از این مسیر است که بیشتر روی بازیابی زیرساختها، Applicationها و دادههای IT تمرکز دارد.
به همین دلیل نباید Business Continuity را با Backup، High Availability یا Disaster Recovery یکی دانست.
یک برنامه واقعی Business Continuity باید از شناخت فرآیندهای حیاتی کسبوکار شروع شود، با BIA، Risk Assessment، RTO و RPO ادامه پیدا کند و در نهایت به معماری فنی، Runbook، Automation و تستهای دورهای منتهی شود.
در زیرساختهای مدرن، طراحی High Availability، Backup، Disaster Recovery، Monitoring و معماریهای Multi-Cluster میتواند بخش مهمی از این مسیر باشد؛ اما انتخاب هر راهکار باید براساس نیاز واقعی کسبوکار انجام شود.
سؤالات متداول
Business Continuity چیست؟
Business Continuity مجموعه سیاستها، فرآیندها و برنامههایی است که به سازمان کمک میکند فعالیتهای حیاتی خود را هنگام وقوع بحران ادامه دهد یا با حداقل وقفه به وضعیت عملیاتی بازگردد.
Disaster Recovery چیست؟
Disaster Recovery مجموعه فرآیندها و زیرساختهایی است که برای بازیابی سیستمهای IT، Applicationها، Databaseها و دادهها پس از یک اختلال یا Disaster طراحی میشوند.
مهمترین تفاوت BC و DR چیست؟
Business Continuity دامنه گستردهتری دارد و کل فعالیتهای حیاتی کسبوکار را پوشش میدهد، در حالی که Disaster Recovery بیشتر روی بازیابی فناوری اطلاعات و زیرساخت تمرکز دارد.
آیا Disaster Recovery بخشی از Business Continuity است؟
بله. DR معمولاً یکی از اجزای مهم برنامه Business Continuity محسوب میشود.
RTO و RPO چه تفاوتی دارند؟
RTO حداکثر زمان قابل قبول برای بازگرداندن سرویس است و RPO مشخص میکند چه میزان Data Loss قابل قبول است.
آیا Backup همان Disaster Recovery است؟
خیر. Backup داده را برای بازیابی نگهداری میکند، اما Disaster Recovery فرآیند، زیرساخت و رویه کامل بازگرداندن سرویس پس از حادثه را نیز شامل میشود.
آیا داشتن دو Data Center به معنی Business Continuity است؟
خیر. چند Data Center میتواند بخشی از استراتژی Continuity و Disaster Recovery باشد، اما فرآیندهای کسبوکار، Data Replication، Traffic Management، افراد، ارتباطات و Recovery Procedure نیز باید طراحی شوند.
چرا تست Disaster Recovery مهم است؟
زیرا داشتن Backup یا DR Site بهتنهایی تضمین نمیکند که Recovery در زمان واقعی موفق باشد. تست میتواند مشکلاتی مانند Backup ناقص، Dependencyهای فراموششده، دسترسیهای نامعتبر یا زمان Recovery بیشتر از RTO را مشخص کند.
طراحی معماری Business Continuity و Disaster Recovery
تداوم کسبوکار یک مسئله صرفاً فنی نیست؛ اما زیرساخت IT بخش مهمی از آن است. طراحی صحیح Backup، High Availability، Monitoring، Disaster Recovery، امنیت و فرآیندهای Recovery میتواند تفاوت قابل توجهی در میزان تأثیر یک بحران بر کسبوکار ایجاد کند.
آلتیمیت کلاد میتواند در ارزیابی زیرساخت، طراحی معماری High Availability و Disaster Recovery، پیادهسازی Backup، طراحی Multi-Data Center و ایجاد فرآیندهای قابل تست برای افزایش تابآوری زیرساخت سازمان همراه شما باشد.
برای بررسی وضعیت فعلی زیرساخت و طراحی مسیر مناسب برای افزایش Business Continuity و Resilience، با آلتیمیت کلاد در ارتباط باشید.