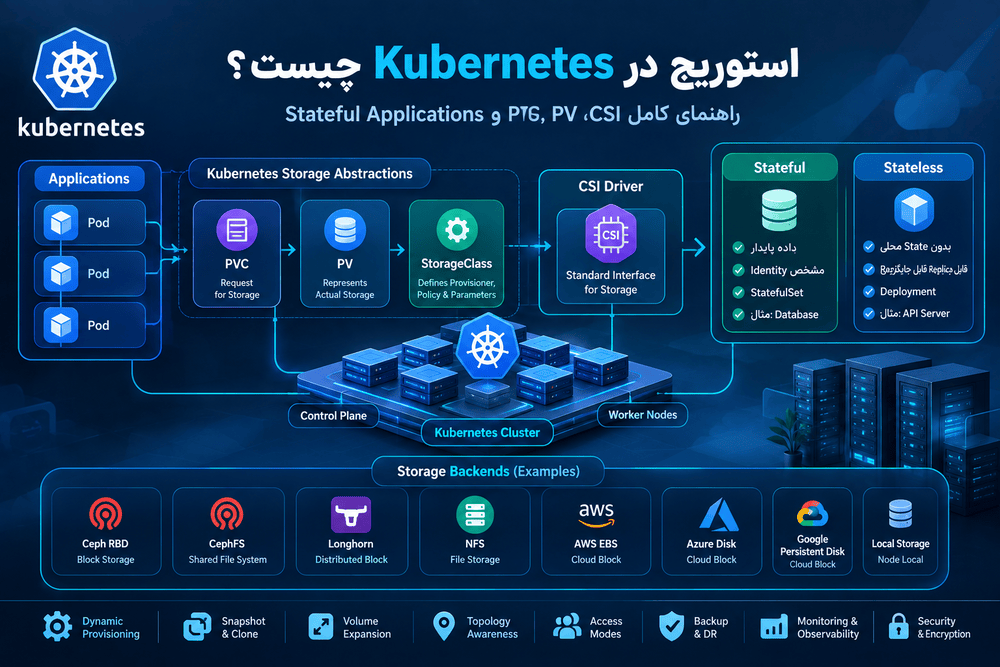
یکی از مهمترین تفاوتهای کوبرنتیز با اجرای ساده Containerها این است که در Kubernetes، Storage دیگر نباید به دیسک یک Container یا حتی یک Node وابسته باشد. وقتی یک Application روی Kubernetes اجرا میشود، Pod ممکن است به دلایل مختلف از یک Node به Node دیگری منتقل شود، حذف و دوباره ساخته شود یا در جریان یک Deployment جدید جایگزین شود؛ بنابراین اگر داده Application داخل Filesystem موقت Container قرار گرفته باشد، با از بین رفتن Container داده نیز میتواند از بین برود.
اینجاست که معماری Storage در Kubernetes اهمیت پیدا میکند.
کوبرنتیس مجموعهای از Abstractionها مانند Volume، PersistentVolume، PersistentVolumeClaim و StorageClass را در اختیار قرار میدهد و از طریق Container Storage Interface یا CSI میتواند به طیف بزرگی از Storage Backendها متصل شود؛ از دیسکهای Block و Storageهای توزیعشده مانند Ceph و Longhorn گرفته تا NFS، Storageهای Cloud و راهکارهای Enterprise.
در طرف دیگر، همه Applicationها به Storage دائمی نیاز ندارند. بعضی Workloadها کاملاً Stateless هستند و میتوانند بدون وابستگی به داده محلی هر Pod اجرا شوند، در حالی که Databaseها، Message Brokerها، بعضی سیستمهای Logging و بسیاری از Stateful Workloadها به Persistence و طراحی دقیق Storage نیاز دارند.
بنابراین برای طراحی صحیح Storage در Kubernetes باید چند سؤال را همزمان پاسخ داد:
- آیا Application ما Stateful است یا Stateless؟
- داده باید بعد از حذف Pod باقی بماند یا نه؟
- Storage از نوع Block است یا File؟
- چند Pod باید همزمان به Volume دسترسی داشته باشند؟
- Storage باید روی یک Node باشد یا بین چند Node قابل دسترسی باشد؟
- چه Performanceای لازم داریم؟
- آیا Snapshot و Clone لازم است؟
- آیا Volume باید قابلیت Resize داشته باشد؟
- اگر یک Node از کار افتاد چه اتفاقی برای داده میافتد؟
- Backup و Disaster Recovery داده چگونه انجام میشود؟
Storage در Kubernetes چرا مهم است؟
Filesystem داخل Container ذاتاً محل مناسبی برای نگهداری دادههای مهم و دائمی نیست. اگر Container از بین برود و Container جدیدی جایگزین آن شود، دادهای که فقط داخل Writable Layer آن Container قرار داشته است، بخشی از چرخه عمر Container بوده و نمیتوان آن را یک Storage پایدار در نظر گرفت.
کوبرنتیز با مفهوم Volume این مشکل را تا حد زیادی حل میکند. یک Volume میتواند عمر متفاوتی نسبت به Container داشته باشد و در حالت Persistent میتواند بعد از حذف یا جایگزینی Pod نیز باقی بماند.
اما یک نکته مهم وجود دارد: Persistent بودن Volume به معنی Backup داشتن نیست.
اگر یک Database روی یک Persistent Volume قرار گرفته باشد، حذف شدن Pod باعث از بین رفتن داده نمیشود؛ اما خرابی Storage Backend، خطای انسانی، Corruption، Ransomware یا حذف اشتباه Volume همچنان میتواند داده را تهدید کند. بنابراین Persistence و Backup دو مفهوم کاملاً متفاوت هستند.
Stateful و Stateless در Kubernetes یعنی چه؟
قبل از ورود به CSI و PV/PVC، باید تفاوت Stateful و Stateless را بهخوبی درک کنیم.
Stateless چیست؟
یک Application را بهصورت ساده میتوان Stateless دانست اگر برای ادامه کار خود به State محلی و دائمی یک Instance خاص وابسته نباشد.
برای مثال یک API Server که:
- Code آن داخل Container Image قرار دارد؛
- Session را داخل Memory محلی نگه نمیدارد؛
- داده اصلی را در Database یا سرویس خارجی ذخیره میکند؛
- و هر Replica میتواند جای Replica دیگر را بگیرد؛
کاندید مناسبی برای اجرای Stateless است.
در چنین معماری، Kubernetes میتواند تعداد زیادی Replica از Application ایجاد کند و در صورت خرابی یک Pod، Pod جدیدی را جایگزین آن کند بدون اینکه Application به Disk همان Pod وابسته باشد.
Stateful چیست؟
یک Workload Stateful معمولاً به داده پایدار، Identity مشخص، ترتیب خاص یا State قابلتوجه وابسته است.
نمونههای رایج:
- PostgreSQL
- MySQL و MariaDB
- MongoDB
- Redis در حالت Persistent
- Kafka
- Elasticsearch و OpenSearch
- RabbitMQ در حالت Persistent
- Prometheus با داده محلی
- سیستمهای ذخیرهسازی و Databaseهای دیگر
البته Stateful بودن صرفاً به این معنی نیست که Application حتماً باید داخل Kubernetes اجرا شود. یک سازمان ممکن است Applicationهای Stateless خود را روی کوبرنتیز اجرا کند اما Database را خارج از Kubernetes و روی Storage یا VMهای اختصاصی نگهداری کند.
یک اشتباه مهم: Stateful ≠ StatefulSet
یکی از رایجترین سوءتفاهمها در Kubernetes این است که تصور کنیم هر Application دارای Storage باید با StatefulSet اجرا شود.
اینطور نیست.
Stateful بودن یک ویژگی معماری Application است؛ StatefulSet یک Kubernetes Workload API برای مدیریت مجموعهای از Podها با Identity پایدار است.
StatefulSet زمانی بسیار مفید است که Podها نیاز به Identity پایدار، Network Identity مشخص یا Storage پایدار داشته باشند. کوبرنتیز نیز StatefulSet را برای Workloadهایی معرفی میکند که به stable identity و persistent storage نیاز دارند.
برای یک API ساده که فقط یک PVC برای نگهداری فایلهای خاص دارد، الزاماً StatefulSet تنها انتخاب نیست. از طرف دیگر، برای Databaseهایی که Replicaهای آنها Identity و Volume مستقل دارند، StatefulSet میتواند انتخاب مناسبی باشد.
معماری کلی Storage در Kubernetes
برای درک Storage در Kubernetes بهتر است مسیر درخواست Storage را از Application تا Backend دنبال کنیم:
Application / Pod
        │
        ▼
PersistentVolumeClaim (PVC)
        │
        ▼
StorageClass
        │
        ▼
CSI Driver
        │
        ├───────────────┐
        ▼               ▼
Controller         Node Plugin
        │               │
        ▼               ▼
Storage Backend   Mount / Attach
        │
        ▼
Block / File / Distributed Storage
در این معماری، Application معمولاً نباید بداند Storage دقیقاً روی چه Disk یا چه Storage Arrayای قرار دارد. Application فقط Storage موردنیاز خود را از طریق PVC درخواست میکند و کوبرنتیس و CSI Driver بخش زیادی از عملیات زیرساختی را مدیریت میکنند.
Volume چیست؟
Volume یک Abstraction برای در اختیار قرار دادن Storage به Containerهای داخل Pod است.
Volume میتواند:
- موقت باشد؛
- از دیسک محلی Node استفاده کند؛
- از یک Storage Backend خارجی استفاده کند؛
- بین چند Container داخل یک Pod به اشتراک گذاشته شود؛
- یا بهصورت Persistent برای مدت طولانی باقی بماند.
Kubernetes انواع مختلفی از Volumeها را پشتیبانی میکند و تفاوت مهم آنها در Lifecycle و Backend آنهاست. Volumeهای Ephemeral به چرخه عمر Pod وابستهاند، در حالی که Persistent Volumeها میتوانند مستقل از عمر یک Pod باقی بمانند.
emptyDir چیست؟
emptyDir یکی از سادهترین Volumeهای Kubernetes است.
وقتی یک Pod روی Node ایجاد میشود، یک Directory برای آن ساخته میشود و Containerهای Pod میتوانند از آن استفاده کنند.
کاربردهای مناسب آن شامل:
- Temporary Files
- Cache
- Scratch Space
- اشتراک فایل بین Containerهای یک Pod
- Intermediate Processing Data
اما emptyDir برای نگهداری دادهای که باید بعد از حذف Pod باقی بماند مناسب نیست.
PersistentVolume یا PV چیست؟
PersistentVolume یا PV یک Storage Resource در Kubernetes است که نماینده یک فضای ذخیرهسازی Persistent است.
PV میتواند توسط Administrator بهصورت Static ایجاد شود یا توسط یک StorageClass و CSI Driver بهصورت Dynamic Provision شود.
بهصورت مفهومی:
Physical / Virtual Storage
          │
          ▼
    PersistentVolume
          │
          ▼
PersistentVolumeClaim
          │
          ▼
         Pod
PV جزئیات Backend را از مصرفکننده جدا میکند.
PersistentVolumeClaim یا PVC چیست؟
PVC درخواست Application برای دریافت Storage است.
برای مثال Application میتواند بگوید:
- من 100GiB Storage میخواهم؛
- میخواهم بهصورت Filesystem استفاده کنم؛
- و به Access Mode مشخصی نیاز دارم.
Application لازم نیست بداند این 100GiB از یک SAN، Ceph، Cloud Disk، NFS یا Storage Backend دیگری آمده است.
این Separation یکی از مهمترین مزایای Storage Abstraction در Kubernetes است.
StorageClass چیست؟
StorageClass مشخص میکند Kubernetes برای Provision کردن یک نوع Storage از چه Provisioner و چه Policyهایی استفاده کند.
برای مثال ممکن است یک Cluster این StorageClassها را داشته باشد:
| StorageClass | Backend | Use Case |
|---|---|---|
| fast-ssd | NVMe / SSD Block Storage | Database و Workloadهای حساس به Latency |
| standard | Distributed Block Storage | Applicationهای عمومی |
| shared-filesystem | CephFS / NFS | Shared Files |
| local-storage | Local Disk | High Performance و Node-local Workload |
| backup-tier | Storage با هزینه کمتر | دادههای کممصرف |
StorageClass علاوه بر Provisioner میتواند Policyهایی مانند Reclaim Policy، Volume Binding Mode، امکان Expansion و پارامترهای اختصاصی Driver را مشخص کند.
برای Volumeهایی که بهصورت Dynamic توسط StorageClass ایجاد میشوند، Reclaim Policy میتواند Delete
یا Retain باشد؛ بنابراین انتخاب این Policy باید با توجه به اهمیت داده انجام شود.
Dynamic Provisioning چیست؟
در روش سنتی، Administrator ابتدا Storage را ایجاد میکرد، PV را تعریف میکرد و سپس Application آن را مصرف میکرد.
در Dynamic Provisioning، Application فقط PVC ایجاد میکند:
Developer
   │
   │ PVC
   ▼
StorageClass
   │
   ▼
CSI Driver
   │
   ▼
Create Volume
   │
   ▼
PersistentVolume
   │
   ▼
Pod
این مدل برای Kubernetes بسیار مهم است، زیرا Provision کردن Storage را به یک فرآیند قابلاتوماسیون تبدیل میکند.
CSI چیست؟
CSI یا Container Storage Interface یک استاندارد برای اتصال Container Orchestratorها به Storage Systemها است.
بهجای اینکه Kubernetes برای هر Storage Vendor یک Plugin اختصاصی داخل Core خود داشته باشد، CSI یک Interface استاندارد ایجاد میکند تا Storage Vendor یا پروژههای Open Source بتوانند Driver خود را ارائه کنند.
به زبان ساده:
Kubernetes
     │
     │ CSI Interface
     ▼
┌─────────────────────┐
│     CSI Driver      │
└─────────────────────┘
     │
     ├── Ceph
     ├── NFS
     ├── Longhorn
     ├── Cloud Disk
     ├── OpenStack Cinder
     └── Enterprise Storage
Kubernetes بهصورت رسمی CSI را برای اتصال به Storageهای مختلف استفاده میکند و Pluginهای قدیمی مانند FlexVolume در مسیر مهاجرت به CSI قرار گرفتهاند و FlexVolume نیز Deprecated شده است.
CSI Driver دقیقاً چه کاری انجام میدهد؟
CSI Driver پل بین Kubernetes و Storage Backend است.
وقتی یک PVC ساخته میشود، Kubernetes میتواند از طریق CSI Driver از Storage Backend درخواست ایجاد Volume کند.
در ادامه، Driver میتواند عملیاتهایی مانند:
- Create Volume
- Delete Volume
- Attach Volume
- Detach Volume
- Mount Volume
- Unmount Volume
- Expand Volume
- Create Snapshot
- Delete Snapshot
- Clone Volume
را بر اساس قابلیتهای Backend و Driver انجام دهد.
معماری CSI Driver
یک CSI Driver معمولاً از دو بخش اصلی تشکیل میشود:
CSI Controller
بخش Controller معمولاً مسئول عملیات Control Plane مانند Provisioning، Attach، Snapshot و Resize است.
CSI Node Plugin
Node Plugin روی Nodeهای Kubernetes اجرا میشود و عملیات مربوط به Node مانند Mount و Publish کردن Volume را انجام میدهد.
به همین دلیل بسیاری از CSI Driverها ترکیبی از یک Deployment برای Controller و یک DaemonSet برای Node Plugin دارند.
برای مثال، AWS EBS CSI Driver نیز Controller و Node Component جداگانه دارد؛ Controller تغییرات منابع Storage در Kubernetes را مدیریت میکند و Node Component روی Nodeها عملیات موردنیاز برای در دسترس قرار دادن Volume را انجام میدهد.
CSI Sidecarها چیستند؟
CSI Driver معمولاً تنها یک Container ساده نیست. در معماری رایج CSI، چند Sidecar نیز وجود دارند که بخشهایی از Integration با Kubernetes را انجام میدهند.
از Sidecarهای متداول میتوان به موارد زیر اشاره کرد:
- csi-provisioner برای Dynamic Provisioning
- csi-attacher برای Attach/Detach
- csi-resizer برای Volume Expansion
- csi-snapshotter برای Snapshot
- node-driver-registrar برای Registration روی Node
- livenessprobe برای Health Checking
در نتیجه یک CSI Driver در عمل مجموعهای از اجزای Controller و Node است که در کنار Kubernetes API و Kubelet عملیات Storage را انجام میدهند.
مهمترین CSI Driverها و Storage Backendها
CSI فقط یک تکنولوژی برای یک Storage خاص نیست. Backendهای بسیار متنوعی میتوانند از طریق CSI به Kubernetes متصل شوند.
Ceph CSI
Ceph یکی از مهمترین گزینهها برای ساخت Storage توزیعشده در محیطهای Private Cloud و On-Premise است.
Ceph CSI حداقل دو Backend مهم را در Kubernetes ارائه میکند:
- Ceph RBD برای Block Storage
- CephFS برای Shared File Storage
Ceph CSI امکان Dynamic Provisioning را فراهم میکند و قابلیتهایی مانند Snapshot، Expansion و Clone بسته به Driver و نسخههای مورد استفاده در دسترس هستند.
معماری کلی:
Kubernetes
    │
    ▼
Ceph CSI
    │
 ┌──┴───────────┐
 ▼              ▼
RBD            CephFS
 │              │
Block         Shared FS
Storage       Storage
Ceph RBD معمولاً برای Workloadهایی که یک Block Device با Performance مناسب میخواهند گزینه جذابی است، در حالی که CephFS برای سناریوهایی که چند Pod باید به یک Filesystem مشترک دسترسی داشته باشند مناسبتر است.
Longhorn
Longhorn یک Distributed Block Storage مبتنی بر Kubernetes است که بهصورت Cloud Native طراحی شده است.
Longhorn Volumeها را در قالب Replicaهای متعدد روی Nodeهای مختلف نگهداری میکند و خود Storage نیز با Kubernetes مدیریت میشود. این پروژه قابلیتهایی مانند Snapshot، Backup به NFS یا S3-compatible Storage و Replication را ارائه میکند.
Longhorn در محیطهایی که تیم میخواهد Storage توزیعشده را با پیچیدگی کمتر از یک Storage Platform بزرگ مانند Ceph در Kubernetes ارائه کند، میتواند گزینه قابل بررسی باشد.
NFS CSI Driver
NFS یکی از قدیمیترین و رایجترین File Storageهاست و میتوان آن را از طریق CSI به Kubernetes متصل کرد.
Official NFS CSI Driver امکان استفاده از یک NFS Server موجود و Dynamic Provisioning از طریق ایجاد Subdirectory برای PVCها را فراهم میکند.
NFS برای سناریوهایی که چند Pod نیاز به Shared Filesystem دارند میتواند مناسب باشد، اما باید Performance، Availability و Failure Domain خود NFS Server نیز در طراحی لحاظ شود.
Cloud Block Storage
Cloud Providerها نیز معمولاً CSI Driver اختصاصی خود را ارائه میکنند.
برای مثال:
- Amazon EBS CSI Driver
- Azure Disk CSI Driver
- Google Persistent Disk CSI Driver
- OpenStack Cinder CSI
برای نمونه، AWS EBS CSI Driver امکان Dynamic Provisioning و قابلیتهایی مانند Snapshot، Expansion و Block Volume را در اختیار Kubernetes قرار میدهد.
Storage در OpenStack و Kubernetes
در Private Cloudهایی که از OpenStack استفاده میکنند، Kubernetes میتواند از طریق Cinder CSI به Block Storage OpenStack متصل شود.
در این معماری:
Kubernetes
     │
     ▼
Cinder CSI
     │
     ▼
OpenStack Cinder
     │
     ▼
Storage Backend
این مدل به Kubernetes اجازه میدهد Storage را از زیرساخت OpenStack بهصورت استاندارد مصرف کند و چرخه Provisioning را تا حد زیادی خودکار کند.
Local Storage چیست؟
در Local Storage، Volume روی Disk همان Node قرار دارد.
مزیت اصلی Local Storage معمولاً Performance بالا و Latency پایین است؛ زیرا مسیر دسترسی به Storage میتواند بدون عبور از Network Storage انجام شود.
اما مشکل مهم آن Node Affinity و وابستگی به Node است.
اگر Volume روی Node شماره ۳ قرار داشته باشد و Node شماره ۳ از دسترس خارج شود، Application نمیتواند مانند یک Volume شبکهای بهسادگی روی Node دیگری به همان داده دسترسی پیدا کند.
بنابراین Local Storage برای همه Stateful Workloadها انتخاب مناسبی نیست و باید Failure Domain آن بهدقت بررسی شود.
HostPath چرا خطرناک است؟
hostPath یک Directory از Filesystem خود Node را به Pod ارائه میکند.
برای Development، ابزارهای خاص Node و بعضی Infrastructure Workloadها ممکن است کاربرد داشته باشد؛ اما استفاده از HostPath بهعنوان Storage اصلی Applicationهای Production معمولاً انتخاب مناسبی نیست.
چرا؟ چون Application به یک Node خاص وابسته میشود.
Pod
 │
 ▼
hostPath
 │
 ▼
Node-01 Disk

Node-01 Down
     │
     ▼
Pod → Node-02

Data روی Node-01 باقی مانده است
در نتیجه باید تفاوت بین Persistent Storage و صرفاً «فایلهایی که روی یک Node باقی میمانند» را در نظر گرفت.
Access Mode در Kubernetes چیست؟
یکی از مهمترین مفاهیم Storage، نحوه دسترسی Podها به Volume است.
Access Modeهای اصلی عبارتاند از:
| Access Mode | مفهوم | مثال کاربرد |
|---|---|---|
| ReadWriteOnce (RWO) | Read/Write توسط یک Node | بسیاری از Block Storageها |
| ReadOnlyMany (ROX) | Read-only از چند Node | دادههای اشتراکی Read-only |
| ReadWriteMany (RWX) | Read/Write از چند Node | NFS، CephFS و File Storageهای مناسب |
| ReadWriteOncePod (RWOP) | Read/Write فقط توسط یک Pod | Workloadهایی که Single-Pod Access میخواهند |
یک نکته بسیار مهم این است که Access Modeها صرفاً بر اساس نام خود نباید تفسیر شوند. پشتیبانی از این Modeها به Storage Backend و CSI Driver بستگی دارد. همچنین Access Mode در Kubernetes در درجه اول برای Matching و Scheduling/Attachment semantics استفاده میشود و نباید آن را با یک مکانیزم عمومی برای Enforce کردن Read-only در تمام Storage Backendها اشتباه گرفت.
RWO به معنی «فقط یک Pod» نیست
این یکی از اشتباهات رایج است.
ReadWriteOnce معمولاً به معنی Read/Write از یک Node است، نه الزاماً یک Pod.
اگر هدف این است که Volume فقط توسط یک Pod بهصورت Read/Write استفاده شود، ReadWriteOncePod مفهوم دقیقتری دارد؛ البته باید بررسی کرد که CSI Driver و Storage Backend از آن پشتیبانی میکنند.
Filesystem یا Raw Block؟
Kubernetes میتواند Volume را به دو شکل اصلی در اختیار Application قرار دهد:
- Filesystem
- Block
در حالت Filesystem، Volume با یک Filesystem مانند ext4 یا XFS Mount میشود و Application با فایلها و Directoryها کار میکند.
در حالت Block، Volume بهصورت Raw Block Device در اختیار Pod قرار میگیرد و خود Application مسئول مدیریت آن است.
Raw Block برای بعضی Workloadهای خاص میتواند مفید باشد، اما برای بسیاری از Applicationهای معمول، Filesystem
انتخاب سادهتر و رایجتری است. Kubernetes نیز volumeMode: Block را برای مصرف Volume بهعنوان Raw
Block Device تعریف میکند.
Volume Binding Mode چیست؟
یکی دیگر از مفاهیم مهم StorageClass، Volume Binding Mode است.
دو حالت مهم:
ImmediateWaitForFirstConsumer
در Immediate، Volume میتواند بلافاصله بعد از ایجاد PVC Provision شود.
در WaitForFirstConsumer، Provisioning تا زمانی که Kubernetes اطلاعات بیشتری درباره محل اجرای Pod
داشته باشد به تعویق میافتد.
این موضوع مخصوصاً برای Storageهایی که به Topology یا Zone یا Node وابسته هستند بسیار مهم است.
Topology در Kubernetes Storage
در Clusterهای چند Zone یا چند Failure Domain، ممکن است Storage در همه Nodeها یا Zoneها قابل دسترسی نباشد.
برای مثال:
Zone A
 ├── Node 1
 └── Node 2
      │
      ▼
   Storage A

Zone B
 ├── Node 3
 └── Node 4
      │
      ▼
   Storage B
اگر Scheduler Pod را روی Zone B قرار دهد ولی Volume فقط در Zone A قابل دسترسی باشد، Application نمیتواند به Storage متصل شود.
CSI و Kubernetes مکانیزمهایی برای درنظر گرفتن Topology و Storage Capacity دارند تا Scheduling بتواند با محدودیتهای Storage هماهنگ شود.
Storage Capacity چیست؟
در بعضی معماریها ظرفیت Storage به Node یا Topology وابسته است.
برای مثال ممکن است یک StorageClass در یک Zone ظرفیت کافی داشته باشد اما در Zone دیگری ظرفیت کافی نداشته باشد.
Kubernetes میتواند با استفاده از CSIStorageCapacity اطلاعات ظرفیت را در اختیار Scheduler قرار دهد تا در هنگام Provisioning و Scheduling، محدودیتهای Storage نیز در نظر گرفته شوند.
Volume Expansion چیست؟
فرض کنید Database شما ابتدا یک Volume با ظرفیت 100GiB دارد و بعد از مدتی این فضا کافی نیست.
در Storage Backendهای مناسب، میتوان PVC را بزرگتر کرد:
100GiB
  │
  ▼
200GiB
  │
  ▼
500GiB
این قابلیت به Volume Expansion معروف است.
یکی از نکات مهم این است که Kubernetes بهطور معمول برای این قابلیت روی رشد Volume تمرکز دارد و کوچک کردن Volume یک عملیات معمول و پشتیبانیشده مانند Expansion نیست. همچنین پشتیبانی واقعی از Expansion به CSI Driver و Backend وابسته است.
Snapshot در Kubernetes
Volume Snapshot امکان ایجاد Snapshot از یک Persistent Volume را فراهم میکند.
این قابلیت برای مواردی مانند:
- Backupهای کوتاهمدت
- قبل از Upgrade
- قبل از Migration
- تست Restore
- ساخت محیط Staging
- Point-in-Time Copy
بسیار مفید است.
در Kubernetes منابعی مانند VolumeSnapshot و VolumeSnapshotClass برای این منظور استفاده
میشوند و قابلیت Snapshot فقط در صورتی در دسترس است که CSI Driver آن را پشتیبانی کند.
اما یک نکته حیاتی:
Snapshot لزوماً Backup نیست.
اگر Snapshot روی همان Storage Backend باقی بماند و آن Storage از بین برود، ممکن است Snapshot نیز از بین برود. برای Disaster Recovery باید Copy مستقل و ترجیحاً خارج از Failure Domain اصلی نیز در نظر گرفته شود.
Volume Clone چیست؟
در CSI میتوان درایورهایی داشت که امکان Clone کردن یک Volume را فراهم میکنند.
در این حالت میتوان یک PVC جدید ایجاد کرد که داده اولیه آن از PVC دیگری گرفته شده باشد.
Production PVC
      │
      │ Clone
      ▼
Staging PVC
      │
      ▼
Testing Environment
Volume Cloning در Kubernetes به CSI Driver وابسته است و Driver باید این قابلیت را پیادهسازی کرده باشد. همچنین Source و Destination باید شرایط موردنیاز Kubernetes و Driver را داشته باشند.
CSI Ephemeral Volume چیست؟
CSI فقط برای Persistent Storage استفاده نمیشود.
برخی CSI Driverها میتوانند Ephemeral Volume نیز ارائه کنند؛ یعنی Volume به چرخه عمر Pod وابسته باشد.
این قابلیت میتواند برای سناریوهایی مفید باشد که Application به یک Storage خاص در طول عمر Pod نیاز دارد اما قرار نیست داده بعد از حذف Pod باقی بماند.
این موضوع نشان میدهد CSI یک Interface صرفاً برای Persistent Disk نیست و میتواند قابلیتهای دیگری را نیز در اختیار Kubernetes قرار دهد.
StatefulSet و Storage چگونه با هم کار میکنند؟
یکی از مهمترین قابلیتهای StatefulSet، استفاده از volumeClaimTemplates است.
برای مثال فرض کنید یک StatefulSet سه Replica دارد:
database-0
   │
   └── database-data-database-0

database-1
   │
   └── database-data-database-1

database-2
   │
   └── database-data-database-2
هر Pod میتواند PVC مخصوص خود را داشته باشد.
در این حالت اگر database-1 از بین برود و Kubernetes آن را دوباره ایجاد کند، Volume مربوط به همان
Identity میتواند دوباره به Pod جدید متصل شود.
StatefulSet برای همین مدل Identity و Storage پایدار بسیار مناسب است. Kubernetes برای StatefulSetها همچنین
Policyهایی برای تعیین رفتار PVCهای ایجادشده از volumeClaimTemplates هنگام حذف یا Scale Down ارائه
میکند.
StatefulSet برای Database چه چیزی را حل میکند و چه چیزی را نه؟
StatefulSet میتواند مواردی مانند:
- Identity پایدار
- Pod Naming
- Stable Network Identity
- Persistent Volume Attachment
- Ordered Scaling
- Ordered Deployment
را مدیریت کند.
اما StatefulSet خودش یک Database Cluster نمیسازد.
برای مثال اگر سه Pod PostgreSQL ایجاد کنید، صرفاً داشتن:
postgres-0
postgres-1
postgres-2
به معنی وجود یک PostgreSQL Cluster سالم و Consistent نیست.
Replication، Leader Election، Failover، Quorum، Backup، Consistency و Recovery باید توسط خود Database یا Operator و معماری مناسب آن مدیریت شوند.
این یکی از مهمترین نکات در اجرای Database روی Kubernetes است.
آیا Database را باید داخل Kubernetes اجرا کنیم؟
پاسخ عمومی و یکسانی برای همه سازمانها وجود ندارد.
اجرای Database روی Kubernetes میتواند مزایایی مانند:
- Automation
- Declarative Management
- Integration با Kubernetes
- Operator-based Lifecycle Management
- Dynamic Provisioning
- Integration با Monitoring و GitOps
داشته باشد.
اما همزمان Complexity نیز افزایش پیدا میکند.
در بسیاری از معماریهای Enterprise باید بررسی شود که آیا بهتر است Database:
- روی Kubernetes باشد؛
- روی VMهای اختصاصی باشد؛
- روی Bare Metal باشد؛
- یا بهصورت Managed Database ارائه شود.
تصمیم نهایی باید بر اساس Performance، Availability، تیم عملیاتی، Backup، Disaster Recovery، Licensing، Complexity و Failure Domain گرفته شود.
Block Storage یا File Storage؟
یکی از مهمترین تصمیمهای Storage انتخاب بین Block و File است.
| ویژگی | Block Storage | File Storage |
|---|---|---|
| مدل دسترسی | Block Device | Filesystem |
| مثال | Ceph RBD، EBS | CephFS، NFS |
| Performance | معمولاً مناسب Workloadهای Database | مناسب Shared Files |
| Shared Access | وابسته به Backend و Driver | معمولاً مناسبتر برای Multi-Node Sharing |
| Database | اغلب انتخاب مناسب | وابسته به Database و Backend |
| Shared Uploads | معمولاً انتخاب اول نیست | مناسب |
Object Storage کجای این معماری قرار میگیرد؟
Object Storage مانند S3 را نباید با Block و File Storage یکی دانست.
Object Storage معمولاً برای دادههایی مانند:
- Backup
- Media
- Images
- Videos
- Artifacts
- Data Lake
- Archive
مناسب است.
Application معمولاً از طریق API به Object Storage متصل میشود، نه اینکه آن را مانند یک Block Device عادی Mount کند.
اگر Application شما فایلهای User را ذخیره میکند، در بسیاری از معماریهای Cloud Native بهتر است بهجای قرار دادن همه فایلها روی PVC، بررسی شود که آیا Object Storage مانند S3 برای آن Use Case مناسبتر نیست.
این تفکیک میتواند معماری را Scalableتر و Storage را مستقلتر از Lifecycle Podها کند.
سه مدل رایج برای نگهداری فایل در Kubernetes
| مدل | مناسب برای | نکته |
|---|---|---|
| Local / Ephemeral | Cache و Temporary Data | نباید بهعنوان Storage دائمی در نظر گرفته شود |
| Persistent Volume | Database، Application Data | نیازمند طراحی Backend و Backup |
| Object Storage | Media، Backup، Artifact، فایلهای بزرگ | API-based و مستقل از Node |
Reclaim Policy چیست؟
فرض کنید PVC حذف شود. چه اتفاقی برای Storage واقعی بیفتد؟
این موضوع با Reclaim Policy مشخص میشود.
Delete
با حذف PVC/PV، Volume Backend نیز میتواند حذف شود.
برای Storage موقتی یا محیطهایی که Lifecycle آنها کاملاً مشخص است ممکن است مناسب باشد.
Retain
Storage بعد از حذف Claim باقی میماند تا Administrator تصمیم بگیرد با آن چه کند.
برای دادههای مهم Production، Retain میتواند لایه محافظتی مهمی در برابر بعضی خطاهای عملیاتی باشد.
اما Retain جایگزین Backup نیست.
Storage و Backup چه رابطهای دارند؟
یک معماری Production باید بین این مفاهیم تفاوت قائل شود:
Persistence
    │
    ▼
Persistent Volume
    │
    ├── Snapshot
    │
    └── Backup
           │
           ▼
     Independent Storage
           │
           ▼
      Disaster Recovery
Persistence برای ادامه کار Application بعد از Restart یا Rescheduling است.
Snapshot یک Point-in-Time Copy از Volume است.
Backup یک Copy با هدف Recovery است.
Disaster Recovery قابلیت بازگرداندن سرویس و داده بعد از یک Failure بزرگ است.
این چهار مفهوم نباید با یکدیگر اشتباه گرفته شوند.
Storage و High Availability
داشتن سه Replica از Application بدون داشتن Storage مناسب، لزوماً High Availability ایجاد نمیکند.
فرض کنید سه Pod به یک Storage وابسته باشند اما Storage فقط روی یک Node وجود داشته باشد.
در این حالت:
Pod A ─┐
Pod B ─┼──> Single Storage Backend
Pod C ─┘
              │
              ▼
          Single Failure
ممکن است Application از نظر Compute چند Replica داشته باشد اما Storage یک Single Point of Failure باقی بماند.
بنابراین در طراحی HA باید حداقل این Failure Domainها بررسی شوند:
- Pod
- Node
- Disk
- Storage Controller
- Storage Network
- Storage Cluster
- Availability Zone
- Data Center
Ceph یا Longhorn؟
هر دو میتوانند برای Kubernetes جذاب باشند اما فلسفه و Complexity آنها متفاوت است.
| موضوع | Ceph | Longhorn |
|---|---|---|
| ماهیت | Distributed Storage Platform | Cloud Native Distributed Block Storage |
| تمرکز | Block، File و قابلیتهای گسترده Storage | Block Storage برای Kubernetes |
| Complexity | بیشتر | معمولاً سادهتر |
| مقیاس | مناسب محیطهای بزرگ و متنوع | مناسب بسیاری از Clusterهای Kubernetes |
| RBD | بله | معادل مستقیم ندارد؛ مدل Block خودش را دارد |
| Shared Filesystem | CephFS | هدف اصلی نیست |
| Backup | وابسته به معماری Ceph و ابزارهای اطراف | Backup به NFS/S3-compatible Storage |
این مقایسه به معنی «بهتر بودن» یکی از آنها نیست. انتخاب Storage باید بر اساس Scale، تیم، Performance، Failure Domain، نیاز به File/Block Storage و مدل عملیاتی سازمان انجام شود.
NFS یا CephFS؟
اگر هدف اصلی Shared Filesystem باشد، NFS و CephFS هر دو میتوانند گزینههایی باشند.
اما معماری آنها متفاوت است.
NFS معمولاً یک File Server یا مجموعهای از Serverهای NFS را در اختیار Kubernetes قرار میدهد، در حالی که CephFS بخشی از یک Distributed Storage Platform است.
بنابراین هنگام انتخاب باید مواردی مانند:
- Availability
- Throughput
- Latency
- Number of Clients
- Failure Recovery
- Operational Complexity
- Backup
- Cost
را بررسی کرد.
Performance در Storage Kubernetes
Storage Performance فقط به عدد IOPS روی Storage Array محدود نمیشود.
برای Workloadهای حساس به Storage باید موارد زیر بررسی شوند:
- IOPS
- Throughput
- Latency
- Queue Depth
- Read/Write Ratio
- Sequential vs Random I/O
- Network Latency
- Filesystem
- Replication Overhead
- CPU Overhead
برای Database معمولاً Latency و Random I/O اهمیت زیادی دارند؛ در حالی که برای Backup یا Streaming Data ممکن است Throughput اهمیت بیشتری داشته باشد.
بنابراین انتخاب «SSD» بهتنهایی یک Storage Architecture محسوب نمیشود.
Storage Performance Class طراحی کنید
در یک Cluster Enterprise بهتر است همه Workloadها از یک StorageClass یکسان استفاده نکنند.
برای مثال:
Storage Classes

fast
 └── NVMe / High IOPS
      └── Database

standard
 └── SSD Distributed Storage
      └── Application Data

shared
 └── CephFS / NFS
      └── Shared Files

archive
 └── Lower Cost Storage
      └── Backup / Archive
این مدل به تیم Platform اجازه میدهد Storage را بهصورت یک سرویس استاندارد و قابلمدیریت در اختیار تیمهای مختلف قرار دهد.
Storage و Kubernetes Scheduling
یکی از اشتباهات رایج این است که Storage را کاملاً جدا از Scheduling در نظر بگیریم.
اما در معماریهای واقعی، محل قرارگیری Pod و محل دسترسی به Storage میتواند به یکدیگر وابسته باشد.
برای مثال:
Pod
 │
 ├── Node Affinity
 │
 ├── Topology
 │
 └── Storage Access
          │
          ▼
      CSI Driver
          │
          ▼
       Backend
در Storageهای Local یا Zone-specific این وابستگی بسیار مهمتر میشود.
Volume Health Monitoring
Storage فقط زمانی مهم نیست که Provision شود؛ باید سلامت آن نیز Monitor شود.
برخی CSI Driverها میتوانند اطلاعاتی درباره وضعیت Volume یا Storage Backend در اختیار Kubernetes قرار دهند. Kubernetes برای CSI Volume Health مکانیزمهایی دارد که میتوانند وضعیتهایی مانند Inaccessible، DataLoss و Degraded را گزارش کنند؛ پشتیبانی عملی این قابلیت به Driver و نسخه مورد استفاده بستگی دارد.
در کنار آن باید Metrics خود Storage Backend نیز مانیتور شوند؛ مانند:
- Latency
- IOPS
- Throughput
- Replication Health
- Disk Usage
- Disk Failure
- Network Errors
- Volume Errors
Storage و Observability
برای یک محیط Production، Monitoring فقط CPU و Memory نیست.
برای Storage نیز باید Metrics و Alertهای مناسب داشته باشیم.
یک معماری Observability میتواند شامل:
- Prometheus برای Metrics
- Grafana برای Visualization
- Log Management برای Storage و CSI Logs
- Alertmanager یا سیستم Alerting مشابه
باشد.
در Kubernetesهای بزرگ، مشاهده وضعیت CSI Controller، Node Plugin، PVC، PV و Backend Storage میتواند برای Troubleshooting بسیار مهم باشد.
مشکلات رایج Storage در Kubernetes
Pending ماندن PVC
اگر PVC در وضعیت Pending بماند، باید مواردی مانند StorageClass، CSI Driver، Capacity، Topology و Provisioner را بررسی کرد.
Mount نشدن Volume
ممکن است Volume Provision شده باشد اما روی Node قابل Mount نباشد.
در این حالت باید CSI Node Plugin، Network، Permissions، Mount Options و Backend را بررسی کرد.
Volume در Node اشتباه
در Storageهای Topology-aware یا Local، ممکن است Pod و Volume با یکدیگر سازگار نباشند.
Disk Full
پر شدن Storage یکی از سادهترین و در عین حال خطرناکترین Failureهاست؛ مخصوصاً برای Databaseها.
IO Latency بالا
ممکن است Application سالم باشد اما Storage Backend دچار Latency شدید شده باشد.
از دست رفتن داده بعد از حذف PVC
این مشکل معمولاً نتیجه انتخاب اشتباه Reclaim Policy یا عملیات اشتباه Administrator است.
چگونه Storage مناسب برای Kubernetes انتخاب کنیم؟
بهتر است بهجای انتخاب Driver بر اساس محبوبیت، ابتدا Requirementها مشخص شوند.
۱. نوع داده
Database است؟ فایل است؟ Backup است؟ Cache است؟ Artifact است؟
۲. Performance
IOPS و Latency موردنیاز چقدر است؟
۳. Access Pattern
یک Pod؟ چند Pod؟ چند Node؟ Read-only یا Read/Write؟
۴. Availability
Storage باید در چند Node یا Zone در دسترس باشد؟
۵. Scalability
آیا حجم Storage در آینده چند برابر میشود؟
۶. Backup
Backup چگونه گرفته و Restore میشود؟
۷. Disaster Recovery
اگر کل Cluster یا Data Center از دسترس خارج شود چه اتفاقی برای داده میافتد؟
۸. Operational Complexity
آیا تیم شما توان مدیریت Ceph یا Storage Cluster پیچیده را دارد؟
۹. Vendor Lock-in
آیا Storage به یک Cloud یا Vendor خاص وابسته است؟
۱۰. Cost
هزینه Disk، Replication، Network، Backup و Operations باید در کنار هم محاسبه شود.
یک Decision Tree ساده برای انتخاب Storage
آیا داده باید Persistent باشد؟
        │
   ┌────┴────┐
   │         │
  No        Yes
   │         │
Ephemeral    │
             ▼
      آیا Shared RWX لازم است؟
             │
       ┌─────┴─────┐
       │           │
      Yes          No
       │           │
CephFS / NFS    Block Storage
                    │
          ┌─────────┴─────────┐
          │                   │
      Cloud Disk        Distributed Block
                            │
                     Ceph RBD / Longhorn
این Decision Tree فقط یک نقطه شروع است و در Production باید Topology، Performance، HA، Backup و DR نیز بررسی شوند.
معماری پیشنهادی Storage برای Kubernetes در Production
برای یک Private Cloud یا On-Premise Cluster میتوان معماری کلی زیر را در نظر گرفت:
                 Kubernetes Cluster
                         │
             ┌───────────┴───────────┐
             │                       │
        Stateless Apps          Stateful Apps
             │                       │
         Deployment             StatefulSet
             │                       │
             │                     PVC
             │                       │
             │                  StorageClass
             │                       │
             │                    CSI Driver
             │                       │
             └───────────────┬───────┘
                             │
                    Storage Platform
                    ┌────────┼─────────┐
                    │        │         │
                   RBD     CephFS     NFS
                    │        │
                    └────┬───┘
                         │
                     Ceph Cluster
                         │
                   Replicated Storage
                         │
              ┌──────────┴──────────┐
              │                     │
           Snapshot              Backup
              │                     │
              └──────────┬──────────┘
                         ▼
                 Secondary Storage
                   / Object Storage
در چنین معماری، Kubernetes مسئول Orchestration است و Storage Platform مسئول Persistence و Durability داده؛ CSI این دو لایه را به یکدیگر متصل میکند.
آیا باید همه Storage را داخل Kubernetes بیاوریم؟
لزومی ندارد.
در بعضی معماریها بهتر است Storage Platform خارج از Kubernetes باشد.
برای مثال یک Ceph Cluster مستقل میتواند Storage را به چند Kubernetes Cluster و حتی VMها و سرویسهای دیگر ارائه کند.
مزیت این مدل این است که:
- Storage Lifecycle مستقل از Kubernetes است؛
- چند Cluster میتوانند از Storage استفاده کنند؛
- Upgrade Kubernetes لزوماً به Storage وابسته نیست؛
- Failure Domainها بهتر جدا میشوند؛
- Storage میتواند بهعنوان یک Platform مستقل مدیریت شود.
در مقابل، راهکارهایی مانند Longhorn عمداً Storage را به Kubernetes نزدیکتر میکنند و برای محیطهایی که Cloud Native Storage میخواهند جذاب هستند.
Storage در Multi-Cluster Kubernetes
در محیطهای Enterprise ممکن است چند Kubernetes Cluster وجود داشته باشد:
             Storage Platform
                    │
        ┌───────────┼───────────┐
        ▼           ▼           ▼
    Cluster A   Cluster B   Cluster C
      Prod       DR/Backup     Dev
در این معماری باید مشخص شود که آیا Storage بین Clusterها Shared است یا هر Cluster Storage مستقل دارد.
برای Disaster Recovery معمولاً بهتر است Copy داده در Failure Domain دیگری وجود داشته باشد تا از دست رفتن Cluster اصلی به معنی از دست رفتن تمام دادهها نباشد.
Storage و Disaster Recovery
اگر Application شما Stateful است، DR بدون طراحی Storage کامل نیست.
باید مشخص شود:
- Backup کجا ذخیره میشود؟
- Snapshot کجا قرار دارد؟
- آیا Backup از Cluster اصلی مستقل است؟
- آیا Backup در Data Center دیگری وجود دارد؟
- Restore چقدر طول میکشد؟
- RPO چقدر است؟
- RTO چقدر است؟
- آیا Restore بهصورت دورهای تست میشود؟
برای همین Storage Design باید بخشی از طراحی کلی Disaster Recovery و Business Continuity باشد، نه یک تصمیم صرفاً فنی درباره Disk.
Storage و GitOps
Storage Configuration در Kubernetes میتواند تا حد زیادی Declarative باشد.
مواردی مانند:
- StorageClass
- StatefulSet
- PVC
- VolumeSnapshotClass
- Backup Configuration
میتوانند بخشی از Repository زیرساخت باشند.
با این حال باید مراقب بود که داده واقعی Application را با Configuration آن اشتباه نگیریم.
Git میتواند تعریف Infrastructure را نگه دارد، اما معمولاً محل مناسبی برای نگهداری خود دادههای Database نیست.
Storage و Security
Storage فقط موضوع Performance و Availability نیست؛ Security نیز اهمیت زیادی دارد.
مواردی که باید بررسی شوند:
- Encryption at Rest
- Encryption in Transit
- Access Control
- RBAC
- Secret Management
- Storage Network Isolation
- Snapshot Access
- Backup Security
- Immutability در Backupهای حساس
- Audit Logging
اگر Backup یا Snapshot از همان Credentialهایی استفاده کند که Production استفاده میکند، compromise شدن Application میتواند Backup را نیز در معرض خطر قرار دهد.
اشتباهات رایج در طراحی Storage Kubernetes
۱. استفاده از Container Filesystem برای داده مهم
Container را جایگزین Storage دائمی نکنید.
۲. استفاده بیدلیل از HostPath
HostPath میتواند Application را به Node خاص وابسته کند.
۳. تصور اینکه StatefulSet مشکل Database را حل میکند
StatefulSet فقط Lifecycle و Identity را مدیریت میکند؛ Database Replication و Consistency موضوع دیگری است.
۴. تصور اینکه PVC یعنی Backup
PVC فقط Persistence را فراهم میکند.
۵. انتخاب Storage بدون بررسی Access Mode
همه Backendها RWX یا RWOP را پشتیبانی نمیکنند.
۶. نادیده گرفتن Topology
در Multi-Zone و Local Storage این موضوع بسیار مهم است.
۷. استفاده از یک StorageClass برای همه Workloadها
Database و Cache و Backup الزاماً به یک Storage Profile نیاز ندارند.
۸. نداشتن Restore Test
Backup بدون تست Restore یک فرض است، نه یک تضمین.
۹. نادیده گرفتن Storage Network
Storage شبکهای به Network سالم و کمLatency وابسته است.
۱۰. اندازهگیری نکردن I/O واقعی Application
قبل از انتخاب Storage باید Workload واقعی را شناخت.
چکلیست Production برای Kubernetes Storage
- نوع Workload مشخص شده است.
- Stateful و Stateless بودن Application مشخص شده است.
- Storage Backend انتخاب شده است.
- CSI Driver رسمی و مناسب استفاده میشود.
- StorageClassهای مختلف برای نیازهای مختلف تعریف شدهاند.
- Access Mode مناسب انتخاب شده است.
- Reclaim Policy بررسی شده است.
- Volume Expansion بررسی شده است.
- Snapshot در صورت نیاز فعال شده است.
- Backup مستقل از Storage اصلی طراحی شده است.
- Restore بهصورت دورهای تست میشود.
- Topology و Failure Domain بررسی شده است.
- Storage Performance اندازهگیری شده است.
- Storage Health و Capacity مانیتور میشوند.
- CSI Controller و Node Plugin مانیتور میشوند.
- Encryption و Access Control بررسی شدهاند.
- RPO و RTO مشخص شدهاند.
- Storage در DR Strategy دیده شده است.
- Storage وابستگی غیرضروری به Node خاص ندارد.
- برای Database، Replication و Consistency جداگانه طراحی شدهاند.
جمعبندی
Storage در Kubernetes بسیار بیشتر از «وصل کردن یک Disk به Pod» است. Kubernetes با Abstractionهایی مانند Volume، PV، PVC و StorageClass یک مدل استاندارد برای مصرف Storage ایجاد میکند و CSI این مدل را به Storage Backendهای مختلف متصل میکند.
از طرف دیگر، طراحی Storage باید با معماری Application هماهنگ باشد. Workloadهای Stateless معمولاً باید تا حد امکان مستقل از Local State طراحی شوند، در حالی که Stateful Workloadها به Persistence، Identity، Storage Lifecycle، Backup و Recovery دقیق نیاز دارند.
StatefulSet نیز خودِ Storage یا Database Cluster نیست؛ بلکه ابزاری برای مدیریت Workloadهایی با Identity و Lifecycle پایدار است. برای Storage واقعی باید Backend، CSI Driver، StorageClass، Access Mode، Topology، Performance، Availability و Backup بهصورت یک مجموعه طراحی شوند.
در محیطهای مختلف میتوان از گزینههایی مانند Ceph RBD، CephFS، Longhorn، NFS، Cloud Block Storage، OpenStack Cinder و Local Storage استفاده کرد. هیچکدام برای تمام سناریوها بهترین انتخاب نیستند؛ انتخاب درست به نوع Workload، Performance، Availability، Failure Domain، پیچیدگی عملیاتی و نیازهای Disaster Recovery بستگی دارد.
در نهایت، یک Kubernetes Production-ready زمانی Storage مناسبی دارد که بتواند در کنار Performance، Persistence، Availability، Scalability، Security و Recoverability را نیز تأمین کند.
آلتیمیت کلاد میتواند در طراحی و پیادهسازی معماری Kubernetes، Private Cloud، Distributed Storage، Ceph، High Availability، Backup و Disaster Recovery، متناسب با نیاز و معماری سازمان، راهکار زیرساختی طراحی و اجرا کند. برای بررسی معماری زیرساخت و انتخاب مدل مناسب Storage، میتوانید از مشاوره تخصصی آلتیمیت کلاد استفاده کنید.
سؤالات متداول درباره Storage در Kubernetes
CSI در Kubernetes چیست؟
CSI یا Container Storage Interface یک استاندارد برای اتصال Kubernetes و سایر Container Orchestratorها به Storage Backendهای مختلف است.
تفاوت PV و PVC چیست؟
PV نماینده Storage موجود در Cluster است، در حالی که PVC درخواست مصرفکننده برای دریافت Storage است.
StorageClass چه کاری انجام میدهد؟
StorageClass مشخص میکند Storage موردنیاز چگونه و توسط چه Provisioner یا CSI Driverای ایجاد شود و چه Policyهایی داشته باشد.
آیا StatefulSet برای تمام Applicationهایی که PVC دارند لازم است؟
خیر. داشتن Persistent Storage الزاماً به معنی استفاده از StatefulSet نیست. StatefulSet زمانی اهمیت بیشتری پیدا میکند که Workload به Identity پایدار، Network Identity یا Storage اختصاصی و پایدار برای Replicaها نیاز داشته باشد.
آیا PVC همان Backup است؟
خیر. PVC Persistence ایجاد میکند، اما Backup برای Recovery در برابر خطای انسانی، خرابی Storage، Data Corruption یا Disaster طراحی میشود.
Ceph بهتر است یا Longhorn؟
هیچ پاسخ عمومی برای همه محیطها وجود ندارد. Ceph یک Storage Platform گسترده با Block و File Storage است، در حالی که Longhorn روی Distributed Block Storage برای Kubernetes تمرکز دارد. انتخاب باید بر اساس Scale، تیم، Performance، Failure Domain و مدل عملیاتی انجام شود.
آیا NFS برای Kubernetes مناسب است؟
بله، در سناریوهایی که Shared File Storage لازم است NFS میتواند گزینه مناسبی باشد؛ اما Availability، Performance، Network و Failure Domain خود NFS باید جداگانه طراحی شوند.
آیا Object Storage جای PVC را میگیرد؟
خیر، این دو برای مدلهای متفاوتی از Storage طراحی شدهاند. PVC برای Volumeهایی است که Application آنها را مانند Block یا Filesystem مصرف میکند، در حالی که Object Storage برای دادههایی است که از طریق API و مدل Object ذخیره و بازیابی میشوند.


