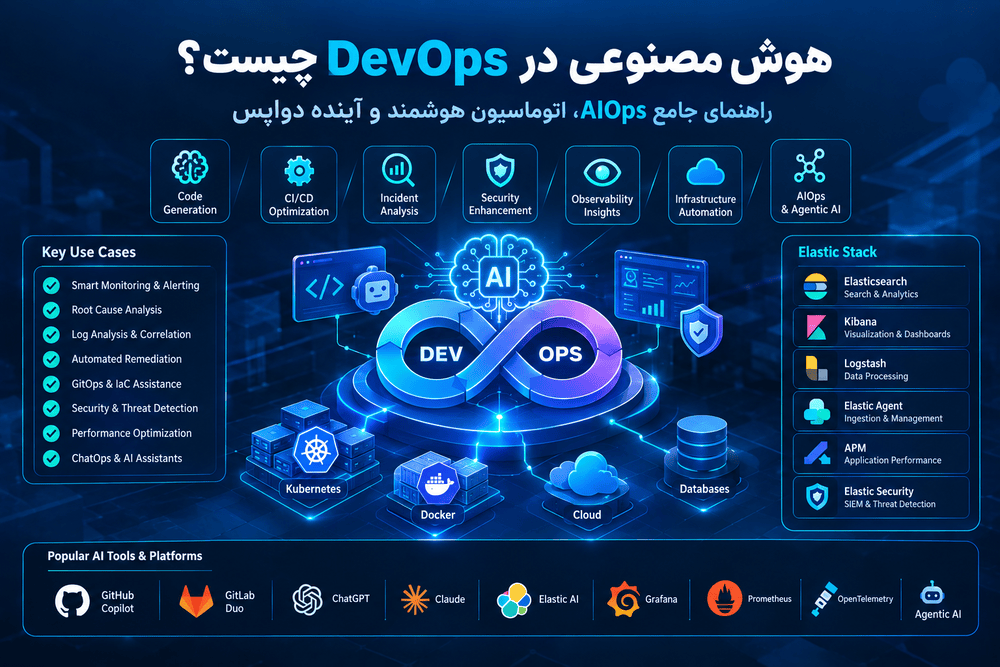
هوش مصنوعی در حال تغییر شیوه طراحی، توسعه، استقرار و نگهداری سیستمهای نرمافزاری است. در گذشته، بسیاری از فعالیتهای تیمهای DevOps به بررسی دستی لاگها، تحلیل هشدارها، نوشتن اسکریپتهای اتوماسیون، عیبیابی رخدادها و مدیریت پیچیدگی زیرساخت اختصاص داشت. امروزه، مدلهای هوش مصنوعی و روشهای یادگیری ماشین میتوانند بخشی از این فعالیتها را تحلیل، تسریع یا خودکار کنند.
بااینحال، هوش مصنوعی در DevOps صرفاً به معنی استفاده از یک دستیار کدنویسی یا تولید اسکریپت با یک مدل زبانی نیست. ارزش واقعی آن زمانی آشکار میشود که دادههای توسعه، خطوط CI/CD، زیرساخت، مانیتورینگ، لاگها، امنیت و فرایندهای عملیاتی به یک جریان کاری منسجم متصل شوند.
در این راهنما، نقش هوش مصنوعی در چرخه عمر نرمافزار را از دیدگاه مهندسی بررسی میکنیم؛ از Generative AI و AIOps گرفته تا تشخیص ناهنجاری، تحلیل علت ریشهای رخدادها، بهینهسازی زیرساخت، امنیت، GitOps و Agentic AI. همچنین ابزارهای مطرح، معماری پیشنهادی، محدودیتها و نقشه راه پیادهسازی در سازمانها را مرور خواهیم کرد.
هوش مصنوعی در DevOps چیست؟
هوش مصنوعی در DevOps به استفاده از تکنیکهایی مانند Machine Learning، پردازش زبان طبیعی، مدلهای زبانی بزرگ (LLM)، تحلیل آماری و عاملهای هوشمند برای بهبود فرایندهای توسعه و عملیات نرمافزار گفته میشود.
این فناوریها میتوانند دادههای عملیاتی را تحلیل کنند، الگوهای غیرعادی را شناسایی کنند، برای حل مشکلات پیشنهاد ارائه دهند، مستندات و پیکربندیها را تولید کنند و در محدودهای مشخص، بعضی از اقدامات عملیاتی را اجرا کنند.
برای مثال، فرض کنید یک سرویس مبتنی بر Kubernetes بهتدریج با افزایش زمان پاسخگویی مواجه شده است. یک سیستم هوشمند میتواند همزمان روند مصرف CPU و حافظه، تعداد درخواستها، خطاهای HTTP، تغییرات اخیر نسخه، لاگهای برنامه و وضعیت دیتابیس را بررسی کند. سپس بهجای ارسال چندین هشدار مستقل، شواهد مرتبط را کنار هم قرار دهد و احتمالهای مختلفی برای علت مشکل پیشنهاد کند.
این فرایند لزوماً به معنی تشخیص قطعی یا رفع خودکار مشکل نیست؛ نتیجه به کیفیت دادهها، ابزارهای موجود، مدل انتخابشده و سطح دسترسی سیستم بستگی دارد. هدف اصلی، کاهش فاصله میان مشاهده مشکل، درک علت آن و اقدام اصلاحی است.
تفاوت AI در DevOps، AIOps و Generative AI چیست؟
این اصطلاحات با یکدیگر ارتباط دارند، اما مترادف نیستند. تفکیک آنها کمک میکند ابزار مناسبتری برای مسئله موردنظر انتخاب کنیم.
| مفهوم | تعریف | کاربرد نمونه |
|---|---|---|
| AI in DevOps | مفهوم کلی استفاده از هوش مصنوعی در چرخه توسعه و عملیات | بهبود توسعه، تست، استقرار، امنیت و نگهداری |
| AIOps | استفاده از هوش مصنوعی و یادگیری ماشین برای تحلیل و بهینهسازی عملیات فناوری اطلاعات | تشخیص ناهنجاری، همبستهسازی هشدارها و تحلیل رخدادها |
| Generative AI | تولید محتوای جدید با استفاده از مدلهای مولد | تولید کد، تست، مستندات، کوئری و اسکریپت |
| LLMOps | مدیریت چرخه عمر و عملیات مدلهای زبانی بزرگ | ارزیابی مدل، کنترل نسخه، پایش کیفیت و مدیریت هزینه |
| Agentic AI | سیستمهایی که با استفاده از مدل، ابزارها و یک فرایند کنترلی، چند مرحله کار را دنبال میکنند | جمعآوری شواهد رخداد، اجرای بررسیهای مجاز و تهیه گزارش |
| Platform Engineering | طراحی پلتفرم داخلی برای ارائه قابلیتهای استاندارد و قابل استفاده مجدد به تیمهای مهندسی | فراهمکردن مسیرهای استاندارد Build، Deploy، Observability و Security |
برای نمونه، تولید یک فایل Docker Compose با کمک مدل زبانی در دسته Generative AI قرار میگیرد. شناسایی رفتار غیرعادی سرویس با تحلیل دادههای متریک میتواند بخشی از AIOps باشد. عاملی که پس از دریافت هشدار، اطلاعات مرتبط را جمعآوری و گزارش رخداد را آماده میکند، به الگوی Agentic AI نزدیک است.
این دستهها همپوشانی دارند؛ یک پلتفرم عملیاتی مدرن ممکن است از هر سه رویکرد استفاده کند.
چرا هوش مصنوعی برای DevOps اهمیت دارد؟
تیمهای مهندسی با افزایش تعداد سرویسها، پیچیدگی معماریهای توزیعشده، حجم لاگها، تعداد استقرارها و الزامات امنیتی روبهرو هستند. در چنین شرایطی، صرفاً افزایش تعداد داشبوردها یا نوشتن اسکریپتهای بیشتر همیشه پاسخگو نیست.
۱. افزایش حجم دادههای عملیاتی
در یک معماری مبتنی بر Microservices و Kubernetes، اطلاعات از منابع مختلفی تولید میشود: لاگ برنامهها، متریکهای سیستمعامل، تریسهای توزیعشده، رویدادهای کلاستر، دیتابیس، Load Balancer و سرویسهای خارجی.
بررسی دستی تمام این دادهها زمانبر است. روشهای هوشمند میتوانند در دستهبندی، خلاصهسازی، تشخیص الگو و پیدا کردن ارتباط میان رویدادها کمک کنند.
۲. کاهش کارهای تکراری
بخشی از زمان مهندسان زیرساخت صرف کارهایی مانند نوشتن اسکریپتهای ساده، تهیه گزارش، ساخت تستهای اولیه، بررسی تغییرات پیکربندی و مستندسازی میشود. هوش مصنوعی میتواند انجام اولیه این کارها را سریعتر کند، به شرط آنکه خروجی آن بررسی و اعتبارسنجی شود.
۳. افزایش پیچیدگی عیبیابی
در سیستمهای توزیعشده، یک خطای ظاهراً ساده ممکن است حاصل ترکیب چند عامل باشد؛ برای مثال افزایش تأخیر دیتابیس، پرشدن Connection Pool، افزایش زمان پاسخگویی یک سرویس خارجی و در نهایت بالا رفتن نرخ Timeout در سرویسهای وابسته.
هوش مصنوعی میتواند شواهد پراکنده را در یک گزارش واحد کنار هم قرار دهد و مسیر بررسی را کوتاهتر کند؛ اما باید میان همبستگی و علت واقعی تمایز قائل شد.
۴. تسریع چرخه توسعه و استقرار
تولید تست، تحلیل خطاهای Pipeline، بررسی Pull Request و پیشنهاد اصلاحات میتواند زمان انتظار تیم را کاهش دهد. بااینحال، اگر سرعت تولید تغییرات افزایش یابد ولی ظرفیت تست، بازبینی و کنترل انتشار بهبود پیدا نکند، نتیجه ممکن است افزایش خطاهای محیط عملیاتی باشد.
کاربردهای هوش مصنوعی در چرخه عمر DevOps
برای پیادهسازی مؤثر، بهتر است هوش مصنوعی را در کل چرخه Software Delivery بررسی کنیم، نه بهعنوان ابزاری جدا از فرایندهای موجود.
| مرحله | کاربرد هوش مصنوعی | خروجی مورد انتظار |
|---|---|---|
| Plan | خلاصهسازی نیازمندیها و تحلیل وابستگیها | برنامهریزی دقیقتر و کاهش ابهام |
| Code | تولید کد، اسکریپت و پیکربندی | کاهش زمان انجام کارهای تکراری |
| Build | تحلیل خطاهای Build و پیشنهاد اصلاح | کاهش زمان عیبیابی |
| Test | تولید تست و تحلیل شکست تستها | بازخورد سریعتر و پوشش بهتر |
| Release | تحلیل ریسک انتشار و خلاصه تغییرات | تصمیمگیری آگاهانهتر برای استقرار |
| Deploy | تحلیل سلامت نسخه و بررسی انحراف از رفتار معمول | تشخیص زودهنگام مشکلات انتشار |
| Operate | تحلیل رخداد، پیشنهاد اقدام و اتوماسیون کنترلشده | کاهش زمان تشخیص و رفع مشکل |
| Secure | تحلیل آسیبپذیری، اولویتبندی ریسک و بررسی تنظیمات | افزایش سرعت رسیدگی به ریسکها |
| Improve | تحلیل شاخصهای تحویل نرمافزار و هزینهها | بهبود مستمر فرایند و معماری |
۱. هوش مصنوعی در توسعه کد و Infrastructure as Code
یکی از در دسترسترین کاربردهای هوش مصنوعی در DevOps، کمک به تولید و بازبینی کد و فایلهای پیکربندی است. این قابلیت فقط به زبانهای برنامهنویسی محدود نمیشود و میتواند در فایلهای YAML، Dockerfile، Helm Chart، Terraform، Ansible و اسکریپتهای Bash یا Python نیز کاربرد داشته باشد.
تولید و اصلاح پیکربندی زیرساخت
یک مهندس میتواند مشخصات اولیه یک سرویس را ارائه کند و از مدل بخواهد نمونهای از پیکربندی موردنیاز را تولید کند. برای مثال:
- ساخت Dockerfile چندمرحلهای برای یک برنامه Node.js
- تولید Kubernetes Deployment، Service و Ingress
- ایجاد Terraform برای تعریف منابع زیرساخت
- نوشتن Ansible Playbook برای نصب و پیکربندی سرویسها
- تولید Pipeline اولیه برای GitLab CI یا GitHub Actions
- تهیه اسکریپتهای بررسی سلامت سرویس و تحلیل فایلهای لاگ
این روش برای تولید پیشنویس اولیه مفید است؛ ولی خروجی باید از نظر نسخه ابزارها، امنیت، محدودیت منابع، ساختار محیط، سازگاری با استانداردهای سازمان و رفتار واقعی بررسی شود.
بازبینی و Refactoring
مدلهای هوش مصنوعی میتوانند تغییرات یک Pull Request را خلاصه کنند، بخشهای پیچیده را توضیح دهند، مشکلات احتمالی را علامتگذاری کنند و پیشنهادهایی برای سادهسازی کد ارائه دهند.
در Infrastructure as Code نیز میتوان از آنها برای شناسایی تنظیمات مشکوک، منابع تکراری، نامگذاری نامنظم و نقض احتمالی استانداردهای داخلی کمک گرفت. بااینحال، تشخیص نهایی خطاهای امنیتی باید به کنترلهای تخصصی و قابل تکرار نیز متکی باشد.
ابزارهای قابل بررسی
- GitHub Copilot: کمک به تولید و توضیح کد، تست و برخی جریانهای کاری توسعه.
- GitLab Duo: قابلیتهای مبتنی بر هوش مصنوعی در جریانهای کاری توسعه و DevSecOps، بسته به محصول و پلن مورد استفاده.
- Claude و ChatGPT: تحلیل کد، تولید اسکریپت، توضیح خطا و کمک به طراحی راهکار؛ نحوه استفاده باید با سیاست محرمانگی سازمان سازگار باشد.
- Continue: چارچوبی برای اتصال دستیارهای هوش مصنوعی به محیط توسعه، با امکان طراحی گردشکارهای متناسب با زیرساخت سازمان.
انتخاب ابزار باید بر اساس زبانها و مخازن مورد استفاده، سطح محرمانگی کد، امکان استقرار خصوصی، هزینه، کیفیت خروجی و سیاستهای امنیتی انجام شود.
۲. هوش مصنوعی در CI/CD
در Pipelineهای سنتی، بسیاری از تصمیمها بر اساس قواعد از پیش تعیینشده گرفته میشوند. برای مثال، در صورت شکست تست، Pipeline متوقف میشود یا در صورت موفقیت Build، مرحله بعدی اجرا میشود. هوش مصنوعی میتواند لایهای برای تحلیل و تصمیمسازی به این جریان اضافه کند؛ اما جایگزین قواعد قطعی و کنترلهای ضروری نیست.
تحلیل هوشمند شکست Pipeline
فرض کنید Pipeline یک پروژه پس از تغییر وابستگیها با خطا مواجه میشود. یک دستیار هوشمند میتواند موارد زیر را بررسی کند:
- متن خطای Build و تست
- تغییرات Commit نسبت به نسخه قبلی
- نسخه زبان، Runtime و وابستگیها
- نتیجه اجرای قبلی Pipelineهای مشابه
- تغییرات محیط اجرا و متغیرهای غیرمحرمانه
سپس میتواند محتملترین مسیرهای بررسی را پیشنهاد دهد. این فرایند، در صورت وجود Context کافی، معمولاً مفیدتر از ارسال یک پیام عمومی درباره شکست Pipeline است.
تولید تست و تحلیل نتایج
هوش مصنوعی میتواند برای توابع، APIها و سناریوهای مشخص تست تولید کند یا مواردی را پیشنهاد دهد که در تستهای فعلی پوشش داده نشدهاند. همچنین میتواند خروجی تستهای طولانی را خلاصه کند و شکستهای مشابه را گروهبندی کند.
بااینحال، تست تولیدشده بهوسیله AI لزوماً تست باکیفیتی نیست. ممکن است همان فرض نادرست کد اصلی را تکرار کند یا بهجای بررسی رفتار مورد انتظار، صرفاً پیادهسازی موجود را تأیید کند. تستها باید بر اساس نیازمندیها و رفتار مورد انتظار بازبینی شوند.
تحلیل ریسک انتشار
یک سیستم هوشمند میتواند در کنار قواعد موجود، اطلاعاتی مانند اندازه تغییرات، سرویسهای درگیر، سابقه شکست استقرار، نتایج تست، تغییرات دیتابیس و وضعیت سرویسهای وابسته را برای ارزیابی ریسک Release در نظر بگیرد.
برای مثال، تغییر کوچک در یک سرویس احراز هویت ممکن است به دلیل وابستگی تعداد زیادی از سرویسها، ریسک بیشتری از تغییر بزرگ در یک صفحه کماهمیت داشته باشد.
خروجی این تحلیل بهتر است در ابتدا به شکل یک گزارش یا پیشنهاد باشد، نه تصمیم قطعی برای جلوگیری یا اجازه انتشار. پس از جمعآوری شواهد کافی، میتوان قواعد کنترلشدهای برای موارد مشخص تعریف کرد.
AI در کنار GitOps
در معماری GitOps، وضعیت مطلوب زیرساخت و برنامهها در مخزن نسخهگذاری میشود و ابزارهایی مانند Argo CD یا Flux آن را با وضعیت واقعی مقایسه و همگامسازی میکنند.
هوش مصنوعی میتواند برای تهیه تغییر پیشنهادی، توضیح Drift، بررسی Manifestها یا تحلیل خطای همگامسازی استفاده شود. بااینحال، بهتر است تغییرات تولیدشده توسط مدل از مسیر Pull Request، بررسی انسانی، تست و سیاستهای استقرار عبور کنند.
به این ترتیب، AI میتواند به تولید و تحلیل تغییر کمک کند، در حالی که Git، Pipeline و ابزار GitOps مسئول کنترل نسخه و اجرای قواعد قابل تکرار باقی میمانند.
برای آشنایی بیشتر با این بخش، مقاله CI/CD چیست؟ و راهنمای فلسفه GitOps و ابزارهایی مانند Argo CD را مطالعه کنید. برای طراحی Pipelineهای سازمانی نیز میتوانید از خدمات CI/CD آلتیمیت کلاد استفاده کنید.
۳. AIOps چیست و چگونه عملیات زیرساخت را هوشمند میکند؟
AIOps از مهمترین حوزههای کاربرد هوش مصنوعی در عملیات فناوری اطلاعات است. هدف آن، کمک به تحلیل دادههای عملیاتی، شناسایی الگوهای غیرعادی، کاهش نویز هشدارها و تسریع فرایند تشخیص و رسیدگی به رخدادهاست.
در یک سیستم عملیاتی، دادهها معمولاً از ابزارهای مختلفی میآیند. Prometheus متریک تولید میکند، Grafana داشبورد و هشدار را نمایش میدهد، Loki یا Elasticsearch لاگها را ذخیره و جستوجو میکنند و ابزارهای APM اطلاعات مربوط به درخواستها و Traceها را جمعآوری میکنند. لایه هوشمند میتواند به تحلیل مشترک این دادهها کمک کند.
تشخیص ناهنجاری (Anomaly Detection)
در مانیتورینگ سنتی، آستانههایی ثابت برای متریکها تعریف میشود. برای مثال، اگر مصرف CPU از ۸۰ درصد عبور کند، هشدار صادر میشود. این روش ساده و قابل فهم است، اما همیشه رفتار واقعی سیستم را منعکس نمیکند.
مصرف ۸۰ درصد CPU ممکن است در زمان پردازش دستهای کاملاً طبیعی باشد، اما در ساعتی که ترافیک معمولاً پایین است، نشانهای از مشکل محسوب شود. همچنین ممکن است یک سرویس پیش از رسیدن به آستانه ثابت، رفتاری غیرعادی نشان دهد.
روشهای تشخیص ناهنجاری میتوانند با توجه به سابقه زمانی، الگوهای ترافیک، تغییرات فصلی و ارتباط میان متریکها، انحراف از رفتار معمول را شناسایی کنند.
این روشها جایگزین تمام آستانههای ثابت نیستند. برای معیارهای حیاتی مانند پرشدن دیسک، از دست رفتن دسترسپذیری یا عبور از محدودیت امنیتی، قواعد صریح همچنان ضروریاند.
همبستهسازی هشدارها (Alert Correlation)
در سیستمهای توزیعشده، یک رخداد ممکن است دهها هشدار ایجاد کند. برای مثال، اختلال در دیتابیس میتواند باعث افزایش تأخیر API، افزایش Timeout، رشد صف پیام و شکست درخواستها در چندین سرویس شود.
اگر هر هشدار بهصورت مستقل بررسی شود، تیم عملیات ممکن است زمان زیادی را صرف تشخیص این موضوع کند که چندین علامت، ناشی از یک مشکل مشترک هستند.
یک لایه تحلیل هوشمند میتواند با استفاده از زمان وقوع، وابستگی سرویسها، شباهت پیامها، Traceها و تغییرات اخیر، هشدارهای مرتبط را در یک گروه قرار دهد. این قابلیت بهویژه زمانی ارزشمند است که توپولوژی سرویسها و دادههای زمانی بهدرستی ثبت شده باشند.
تحلیل علت ریشهای (Root Cause Analysis)
تحلیل علت ریشهای فقط به یافتن یک خطای ظاهری محدود نیست؛ هدف، پیدا کردن عامل یا زنجیره عواملی است که باعث اختلال شدهاند.
هوش مصنوعی میتواند برای تحلیل این اطلاعات به کار رود:
- متریکهای سیستم، سرویس و دیتابیس
- لاگهای برنامه و زیرساخت
- Distributed Tracing و وابستگی درخواستها
- رویدادهای Kubernetes و تغییرات پیکربندی
- تاریخچه استقرار و تغییرات اخیر
- سوابق رخدادها و راهکارهای قبلی
برای مثال، افزایش Latency ممکن است همزمان با بالا رفتن مصرف CPU در دیتابیس و افزایش تعداد Connectionهای فعال رخ دهد. سیستم میتواند این شواهد را کنار هم قرار دهد و احتمال وجود مشکل در Queryها یا Connection Pool را مطرح کند.
بااینحال، همزمانی دو رویداد بهتنهایی اثبات رابطه علت و معلولی نیست. گزارش هوشمند باید شواهد، فرضیهها و میزان عدم قطعیت را از هم جدا کند.
تولید خلاصه رخداد و گزارش Postmortem
پس از یک رخداد عملیاتی، مهندسان باید زمانبندی اتفاقات، سرویسهای آسیبدیده، اقدامات انجامشده و درسآموختهها را ثبت کنند. مدلهای زبانی میتوانند از روی Timeline، پیامهای ثبتشده و دادههای رخداد، پیشنویس گزارش تهیه کنند.
این کار مستندسازی را سادهتر میکند، اما گزارش نهایی باید توسط افراد درگیر بررسی شود؛ بهخصوص در مورد علت رخداد، تأثیر تجاری، مسئولیتها و اقدامات اصلاحی.
برای ایجاد پایه فنی این معماری، پیادهسازی مانیتورینگ حرفهای، مدیریت لاگ و ابزارهای Observability ضروری است. مقالههای OpenTelemetry چیست؟ و Observability چیست؟ نیز به درک این لایه کمک میکنند.
۴. هوش مصنوعی در Observability؛ فراتر از مانیتورینگ سنتی
Monitoring معمولاً بررسی میکند که یک معیار از محدوده مشخص خارج شده است یا خیر. Observability تلاش میکند با استفاده از خروجیهای سیستم، وضعیت داخلی و رفتار آن را بهتر درک کنیم.
سه منبع اصلی داده در Observability عبارتاند از:
- Metrics: دادههای عددی مانند نرخ درخواست، CPU، حافظه، خطا و Latency.
- Logs: رویدادها و پیامهای ثبتشده توسط برنامه و زیرساخت.
- Traces: مسیر عبور یک درخواست میان سرویسهای مختلف.
هوش مصنوعی میتواند این دادهها را در کنار اطلاعات مربوط به تغییرات نسخه، وابستگیها و رخدادهای زیرساخت تحلیل کند. به این ترتیب، بهجای بررسی جداگانه چند داشبورد، یک دیدگاه یکپارچهتر از وضعیت سیستم ایجاد میشود.
نقش LLM در تحلیل Observability
مدلهای زبانی برای تعامل با دادههای عملیاتی چند کاربرد مهم دارند:
- تبدیل پرسش طبیعی به کوئری مناسب، با رعایت محدودیتهای دسترسی.
- خلاصهسازی حجم زیادی از لاگها و پیامهای خطا.
- توضیح روندهای مشاهدهشده در نمودارها و متریکها.
- ساخت Timeline از رخدادهای مرتبط.
- تهیه گزارش اولیه برای تیمهای فنی و مدیریتی.
- پیشنهاد مراحل عیبیابی بر اساس مستندات داخلی.
برای مثال، مهندس میتواند بپرسد: «چرا نرخ خطای سرویس پرداخت پس از آخرین استقرار افزایش پیدا کرده است؟» سامانه مناسب باید ابتدا دادههای مجاز را از منابع مشخص جمعآوری کند، سپس شواهد مرتبط را ارائه دهد و در نهایت، فرضیهها و مسیرهای بررسی را پیشنهاد کند.
نکته مهم این است که مدل نباید صرفاً با تکیه بر یک متن خلاصهشده، ادعای قطعی درباره سلامت سیستم داشته باشد. دسترسی به دادههای اصلی، امکان بررسی شواهد و ثبت منبع هر نتیجه اهمیت زیادی دارد.
ابزارها و اجزای قابل استفاده
- OpenTelemetry: استاندارد و مجموعه ابزارهای جمعآوری و انتقال Telemetry؛ بهخودیخود یک موتور هوش مصنوعی نیست، اما میتواند داده لازم برای تحلیل را فراهم کند.
- Prometheus و Grafana: برای جمعآوری متریک، هشدار و مشاهده وضعیت سیستم.
- Grafana Loki: برای مدیریت و جستوجوی لاگها.
- Elasticsearch و Kibana: برای جستوجو، تحلیل داده و بررسی لاگها و رویدادها.
- APM و Distributed Tracing: برای مشاهده مسیر درخواستها و عملکرد سرویسهای وابسته.
- LLM و Agent Framework: برای خلاصهسازی، تولید کوئری، استفاده کنترلشده از ابزارها و ارائه گزارش.
این ابزارها نقشهای متفاوتی دارند و همه آنها به قابلیت AI یکسانی مجهز نیستند. باید قابلیتهای بومی هر محصول را از معماری سفارشیای که سازمان روی آن پیادهسازی میکند، جدا کرد.
۵. هوش مصنوعی در مدیریت Kubernetes و زیرساخت ابری
در محیطهای مبتنی بر Kubernetes، تعداد زیاد منابع، محدودیتهای CPU و حافظه، وابستگی سرویسها و تغییرات پیوسته میتواند مدیریت زیرساخت را پیچیده کند. هوش مصنوعی میتواند در تحلیل این پیچیدگی به مهندسان کمک کند.
تحلیل مشکلات کلاستر
مدل هوشمند میتواند خروجی دستورات تشخیصی، وضعیت Podها، رویدادهای کلاستر، لاگهای Containerها و تغییرات اخیر را بررسی کند. برای مثال، در مواجهه با وضعیت CrashLoopBackOff میتواند مسیر بررسی را بر اساس علتهای محتمل مانند خطای برنامه، تنظیمات اشتباه، شکست Probe یا محدودیت منابع پیشنهاد دهد.
این قابلیت به معنی حل خودکار تمام مشکلات Kubernetes نیست. برای تشخیص صحیح، اطلاعاتی مانند رویدادهای Namespace، وضعیت Nodeها، Exit Code، تنظیمات Probe و لاگهای زمان وقوع خطا اهمیت دارند.
بهینهسازی منابع و ظرفیت
هوش مصنوعی میتواند در تحلیل روند مصرف منابع و پیشنهاد تغییر در Request و Limit، تعداد Replicaها یا ظرفیت زیرساخت کمک کند. این تحلیل میتواند رفتار ترافیک، الگوی مصرف در ساعات مختلف و تغییرات عملکرد سرویس را در نظر بگیرد.
بااینحال، پیشنهاد منابع کمتر همیشه به معنی بهینهسازی نیست. کاهش بیش از حد حافظه ممکن است باعث OOMKill شود و افزایش نامناسب تعداد Replicaها میتواند فشار بیشتری بر دیتابیس یا سرویسهای وابسته وارد کند.
بهتر است پیشنهادها ابتدا در محیط آزمایشی یا به شکل گزارش ارائه شوند و سپس با استفاده از Load Test، SLOها و محدودیتهای هزینه بررسی شوند.
تشخیص Drift و خطاهای پیکربندی
در زیرساختهای مبتنی بر Terraform و GitOps، هوش مصنوعی میتواند تفاوت میان وضعیت مورد انتظار و وضعیت واقعی را توضیح دهد، تغییرات مشکوک را مشخص کند و برای اصلاح آنها پیشنهاد تهیه کند.
برای مثال، اگر تنظیمات یک سرویس در محیط عملیاتی با تعریف موجود در مخزن تفاوت داشته باشد، مدل میتواند تغییرات را خلاصه و پیامدهای احتمالی آنها را توضیح دهد. اجرای اصلاحات باید از مسیر کنترلشده و متناسب با سیاستهای سازمان انجام شود.
برای پیادهسازی این قابلیتها، زیرساخت استاندارد مبتنی بر کانتینریزیشن و کوبرنتیس، مقیاسپذیری و High Availability اهمیت دارد.
۶. هوش مصنوعی در DevSecOps و امنیت زیرساخت
افزودن هوش مصنوعی به DevOps بدون توجه به امنیت میتواند ریسکهای تازهای ایجاد کند. از سوی دیگر، در صورت طراحی درست، AI میتواند به تحلیل سریعتر یافتههای امنیتی، شناسایی تنظیمات نامناسب و اولویتبندی اقدامات اصلاحی کمک کند.
تحلیل آسیبپذیریها
ابزارهای SAST، DAST، اسکن وابستگیها، اسکن Imageها و اسکن تنظیمات زیرساخت، یافتههای امنیتی تولید میکنند. بخشی از این یافتهها تکراری یا وابسته به شرایط محیط هستند.
هوش مصنوعی میتواند توضیح دهد که یک آسیبپذیری در چه شرایطی اهمیت پیدا میکند، کدام سرویسها ممکن است در معرض خطر باشند و چه اصلاحاتی باید بررسی شوند. تصمیم نهایی باید بر اساس شواهد فنی، شدت آسیبپذیری، قابلیت بهرهبرداری و میزان مواجهه واقعی گرفته شود.
بررسی تنظیمات زیرساخت
در Kubernetes، Docker، Terraform و تنظیمات سرور میتوان از هوش مصنوعی برای بازبینی اولیه مواردی مانند دسترسی بیش از حد، پورتهای غیرضروری، پیکربندی TLS، تنظیمات شبکه و سیاستهای امنیتی استفاده کرد.
این بررسی باید مکمل ابزارهای تخصصی و Policy-as-Code باشد، نه جایگزین آنها. قواعد امنیتی حیاتی بهتر است بهصورت خودکار، تکرارپذیر و مستقل از پاسخ احتمالی مدل اعمال شوند.
شناسایی تهدید و تحلیل رخداد امنیتی
در محیطهای سازمانی، تحلیل حجم زیادی از رویدادهای امنیتی ممکن است زمانبر باشد. مدلهای هوشمند میتوانند به خلاصهسازی رویدادها، گروهبندی فعالیتهای مرتبط، تهیه Timeline و کمک به Threat Hunting بپردازند.
برای مثال، ترکیب رویدادهای ورود ناموفق، تغییر غیرمنتظره سطح دسترسی و ارتباط مشکوک شبکه میتواند برای بررسی بیشتر اولویت بگیرد. بااینحال، هر الگوی غیرعادی الزاماً به معنی حمله نیست و باید احتمال مثبت کاذب نیز در نظر گرفته شود.
ریسکهای امنیتی خود هوش مصنوعی
- نشت اطلاعات: ارسال کد، لاگ، توکن یا داده مشتری به سرویسهای خارجی بدون مجوز.
- Prompt Injection: تلاش محتوای غیرقابل اعتماد برای تغییر رفتار عامل هوشمند.
- اجرای دستور مخرب: تولید یا اجرای فرمانی که باعث حذف داده، اختلال سرویس یا تغییر ناخواسته زیرساخت شود.
- تولید کد ناامن: ارائه راهکاری که ظاهراً درست است، اما کنترل دسترسی یا مدیریت ورودی را نادیده میگیرد.
- دسترسی بیش از حد: اعطای مجوزهای مدیریتی گسترده به عامل هوشمند.
برای کاهش این ریسکها باید از حداقل دسترسی، مدیریت امن Secrets، محدودیت شبکه، ثبت ممیزی، محیط اجرای ایزوله و کنترل انسانی برای اقدامات حساس استفاده کرد.
برای تکمیل این لایه، راهنمای DevSecOps چیست؟ و صفحه خدمات امنیت و هاردنینگ را ببینید.
۷. Agentic AI و اتوماسیون هوشمند عملیات
یکی از مسیرهای مهم توسعه هوش مصنوعی در عملیات، استفاده از عاملهایی است که میتوانند چند مرحله را در قالب یک جریان کاری دنبال کنند. این عاملها ممکن است به مدل زبانی، ابزارهای جستوجو، APIهای مانیتورینگ، مستندات داخلی و سیستم مدیریت رخداد متصل شوند.
تفاوت اصلی Agentic AI با یک چتبات ساده، امکان برنامهریزی محدود، استفاده از ابزارها، جمعآوری نتیجه مراحل قبلی و ادامه کار بر اساس شواهد است. البته میزان خودمختاری به طراحی سیستم وابسته است و هر عامل هوشمندی لزوماً قادر به تصمیمگیری مستقل و قابل اعتماد نیست.
نمونه جریان کاری یک عامل عملیاتی
- هشدار افزایش خطای یک سرویس دریافت میشود.
- عامل اطلاعات رخداد و زمان شروع آن را از سیستم مانیتورینگ دریافت میکند.
- لاگها، Traceها و متریکهای مرتبط را در محدوده مجاز بررسی میکند.
- تغییرات اخیر نسخه و پیکربندی را مقایسه میکند.
- شواهد، فرضیههای محتمل و میزان اطمینان را در گزارشی ساختاریافته ارائه میدهد.
- در صورت وجود Runbook معتبر، مراحل تشخیصی کمخطر را پیشنهاد یا اجرا میکند.
- برای اقدام حساس، مانند Rollback یا تغییر ظرفیت، تأیید فرد مجاز را درخواست میکند.
- نتیجه اقدامات و اطلاعات رخداد را ثبت میکند.
چنین معماریای میتواند زمان لازم برای جمعآوری شواهد را کاهش دهد. بااینحال، اگر دادههای ورودی ناقص باشند یا عامل به ابزار اشتباه دسترسی داشته باشد، ممکن است نتیجه نادرستی ارائه دهد.
سطوح مختلف خودکارسازی
| سطح | نحوه عملکرد | نمونه | ریسک نسبی |
|---|---|---|---|
| ۱. تحلیل | فقط دادهها را بررسی و گزارش میکند | خلاصهسازی لاگها | کمتر |
| ۲. پیشنهاد | راهکار ارائه میدهد، اما اقدامی انجام نمیدهد | پیشنهاد Rollback | کم تا متوسط |
| ۳. اجرای تأییدشده | پس از تأیید انسان اقدام میکند | افزایش Replicaها با تأیید اپراتور | متوسط |
| ۴. اجرای خودکار محدود | در چارچوب سیاستهای از پیش تعریفشده اقدام میکند | اجرای Runbook کمخطر برای بازیابی یک سرویس | وابسته به دامنه و کنترلها |
| ۵. خودمختاری گسترده | چندین تصمیم و اقدام را بدون تأیید موردی دنبال میکند | مدیریت مستقل یک رخداد پیچیده | بالا و نیازمند کنترل جدی |
برای محیطهای حساس و سازمانی، شروع از سطوح تحلیل و پیشنهاد معمولاً منطقیتر است. حرکت به سمت اجرای خودکار باید بر اساس شواهد، تست، محدودیت دسترسی، امکان Rollback و ارزیابی ریسک انجام شود.
۸. ابزارهای هوش مصنوعی در DevOps
هیچ ابزار واحدی تمام نیازهای AI در DevOps را پوشش نمیدهد. انتخاب مناسب به این بستگی دارد که هدف اصلی، کمک به توسعهدهنده است یا تحلیل رخداد، مدیریت زیرساخت، امنیت یا ساخت عاملهای عملیاتی.
| ابزار یا خانواده | حوزه اصلی | نکته مهم |
|---|---|---|
| GitHub Copilot | توسعه کد و کمک در گردشکار مهندسی | کنترل کد تولیدشده و سیاستهای مخزن ضروری است. |
| GitLab Duo | قابلیتهای AI در جریان توسعه و DevSecOps | قابلیتها به نسخه، پلن و پیکربندی وابستهاند. |
| ChatGPT و Claude | تحلیل کد، مستندات، خطا و طراحی راهکار | حریم خصوصی داده و نحوه اتصال به ابزارها باید بررسی شود. |
| Elastic و قابلیتهای AI آن | جستوجو، تحلیل لاگ و دادههای عملیاتی | قابلیتهای AI به محصول، نسخه و معماری وابستهاند. |
| Grafana و اکوسیستم Observability | مشاهدهپذیری، متریک و لاگ | قابلیت تحلیل هوشمند به اجزای انتخابشده بستگی دارد. |
| Prometheus | جمعآوری متریک و هشدار | خود Prometheus بهتنهایی پلتفرم AIOps نیست. |
| OpenTelemetry | جمعآوری و انتقال Telemetry | لایه تأمین داده است، نه مدل AI. |
| n8n و ابزارهای Workflow Automation | اتصال سرویسها و اجرای جریانهای کاری | مجوزها و اعتبارسنجی هر اقدام باید جداگانه طراحی شوند. |
| LangGraph و چارچوبهای Agent | طراحی گردشکارهای چندمرحلهای مبتنی بر مدل | مدیریت State، خطا، دسترسی و کنترل حلقهها مهم است. |
| مدلهای محلی مانند خانواده Qwen یا Llama | ساخت راهکارهای مبتنی بر مدلهای قابل استقرار خصوصی | کیفیت، منابع سختافزاری، مجوز و نیازمندی زبان باید ارزیابی شوند. |
چگونه ابزار مناسب انتخاب کنیم؟
بهجای انتخاب ابزار بر اساس شهرت یا تعداد قابلیتهای تبلیغشده، ابتدا مسئله عملیاتی را مشخص کنید. برای مثال، اگر مشکل اصلی زمان طولانی عیبیابی است، ابتدا کیفیت لاگها، متریکها و ارتباط میان سرویسها را بررسی کنید. خرید ابزار AI بدون داشتن داده قابل اعتماد، معمولاً ارزش محدودی ایجاد میکند.
معیارهای ارزیابی میتوانند شامل موارد زیر باشند:
- امکان استقرار Self-hosted یا On-premises
- میزان سازگاری با Kubernetes، GitLab، Argo CD و ابزارهای موجود
- امکان کنترل سطح دسترسی و ثبت Audit Log
- هزینه مدل، زیرساخت و نگهداری
- کیفیت پاسخ در سناریوهای واقعی سازمان
- قابلیت ارائه شواهد و ارجاع به منابع داخلی
- پشتیبانی از مدلها و ارائهدهندگان مختلف
- قابلیت اندازهگیری کیفیت و مقایسه با فرایند فعلی
۹. معماری پیشنهادی برای پیادهسازی AI در DevOps
در یک معماری سازمانی، بهتر است لایه جمعآوری داده، ذخیرهسازی، تحلیل، مدل هوش مصنوعی و اجرای اقدامات از یکدیگر تفکیک شوند. این جداسازی باعث میشود بتوان رفتار سیستم را کنترل کرد و در صورت تغییر مدل یا ابزار، کل زیرساخت را از ابتدا بازطراحی نکرد.
لایه اول: منابع داده
این لایه شامل Git، CI/CD، Kubernetes، سیستمعامل، دیتابیس، ابزارهای مانیتورینگ، لاگ، APM، سیستم مدیریت رخداد و مستندات داخلی است. کیفیت دادهها و همزمانسازی زمانی آنها نقش مهمی در نتیجه تحلیل دارد.
لایه دوم: جمعآوری و یکپارچهسازی
ابزارهایی مانند OpenTelemetry، Prometheus، Elastic Agent و جمعآورندههای لاگ میتوانند دادهها را به سامانههای مربوط منتقل کنند. در این مرحله باید اطلاعات حساس حذف یا ماسک شوند و دسترسیها بهصورت حداقلی تعریف شوند.
لایه سوم: تحلیل و Context
دادههای خام باید به اطلاعاتی تبدیل شوند که برای مسئله موردنظر معنا داشته باشند. این مرحله ممکن است شامل همبستهسازی رخدادها، ساخت شاخصهای آماری، جستوجوی اسناد، دریافت اطلاعات تغییرات اخیر و اتصال به دانشنامه داخلی باشد.
برای استفاده از مستندات سازمانی، میتوان از Retrieval-Augmented Generation یا RAG کمک گرفت تا مدل هنگام پاسخگویی، اسناد مرتبط را بازیابی کند. کیفیت RAG به کیفیت اسناد، روش بازیابی، کنترل دسترسی و نحوه ارزیابی پاسخها وابسته است.
لایه چهارم: مدل و عامل هوشمند
مدل میتواند متنها را خلاصه کند، کوئری پیشنهاد دهد، شواهد را تحلیل کند یا یک برنامه عملیاتی محدود بسازد. در این لایه باید ورودی، خروجی، ابزارهای مجاز، محدودیت زمان و هزینه و رفتار در شرایط خطا مشخص شوند.
لایه پنجم: سیاستها و اجرای کنترلشده
اجرای اقداماتی مانند تغییر Replicaها، Rollback، Restart سرویس یا تغییر تنظیمات باید از یک لایه کنترل عبور کند. این لایه میتواند Policy-as-Code، بررسی مجوز، تأیید انسانی، محدودیت دامنه، ثبت Audit Log و امکان بازگشت را اعمال کند.
لایه ششم: ارزیابی و بازخورد
پس از هر پیشنهاد یا اقدام، نتیجه واقعی باید ثبت شود. آیا علت پیشنهادی درست بود؟ آیا اقدام انجامشده مشکل را حل کرد؟ آیا اثر جانبی ایجاد شد؟ آیا زمان رسیدگی کاهش پیدا کرد؟ این دادهها برای ارزیابی کیفیت سیستم و بهبود گردشکار ضروریاند.
یک نمای ساده از این معماری:
Git / CI-CD / Kubernetes / Metrics / Logs / Traces
                         |
                         v
             Data Collection & Integration
                         |
                         v
       Context, Correlation & Knowledge Retrieval
                         |
                         v
                AI Model / Agent
                         |
                         v
           Policy Engine & Access Controls
                         |
             +-----------+-----------+
             |                       |
             v                       v
      Human Approval           Safe Automation
             |                       |
             +-----------+-----------+
                         |
                         v
             Audit, Evaluation & Feedback
در این طراحی، مدل هوش مصنوعی مستقیماً و بدون کنترل به زیرساخت دسترسی ندارد. عامل فقط میتواند از ابزارهای مشخصی استفاده کند که سطح دسترسی و رفتار آنها از قبل تعریف شده است.
۱۰. استفاده از هوش مصنوعی در محیطهای Self-hosted و سازمانی
برای سازمانهایی که کد، لاگها، اطلاعات مشتری یا جزئیات زیرساخت حساس دارند، محل پردازش داده یکی از تصمیمهای کلیدی است. استفاده از سرویس خارجی ممکن است از نظر کیفیت و سرعت مناسب باشد، اما باید شرایط نگهداری داده، سیاستهای قراردادی، الزامات قانونی و محدودیتهای دسترسی بررسی شود.
در مقابل، اجرای مدل روی زیرساخت اختصاصی میتواند کنترل بیشتری بر دادهها فراهم کند، ولی مسئولیت تأمین GPU یا CPU، حافظه، بهروزرسانی مدل، امنیت، مقیاسپذیری و پایش عملکرد را نیز به سازمان منتقل میکند.
| رویکرد | مزایا | محدودیتها |
|---|---|---|
| مدل مدیریتشده خارجی | شروع سریعتر و کاهش مسئولیت نگهداری مدل | وابستگی به ارائهدهنده و نیاز به بررسی انتقال داده |
| مدل Self-hosted | کنترل بیشتر بر محل پردازش و امکان سفارشیسازی | نیاز به زیرساخت، ارزیابی مدل و تیم نگهداری |
| معماری ترکیبی | امکان تفکیک بارهای حساس از کاربردهای عمومی | پیچیدگی بیشتر در مدیریت داده، دسترسی و هزینه |
Self-hosted بودن بهتنهایی تضمینکننده امنیت نیست. مدل محلی همچنان به کنترل دسترسی، جداسازی شبکه، مدیریت Secrets، وصلههای امنیتی، ثبت رخداد و سیاست نگهداری داده نیاز دارد.
برای سازمانهایی که به معماری اختصاصی نیاز دارند، راهکارهای ابر خصوصی سازمانی و راهکارهای سازمانی آلتیمیت کلاد میتوانند بخشی از طراحی زیرساخت مناسب برای این نوع بارهای کاری باشند.
۱۱. چه زمانی نباید از هوش مصنوعی برای اتوماسیون استفاده کنیم؟
هر فرایند تکراری الزاماً به هوش مصنوعی نیاز ندارد. اگر مسئله را میتوان با یک Rule، اسکریپت قطعی یا Pipeline ساده و قابل اعتماد حل کرد، افزودن مدل ممکن است هزینه و پیچیدگی غیرضروری ایجاد کند.
برای مثال، Restart کردن یک سرویس در شرایط مشخص ممکن است با یک Health Check و سیاست بازیابی استاندارد انجام شود. استفاده از مدل زبانی برای تصمیمگیری درباره همان اقدام، بدون نیاز واقعی به تحلیل زمینه، لزوماً ارزش بیشتری ندارد.
موارد زیر نیازمند احتیاط ویژهاند:
- حذف منابع زیرساخت یا دادههای پایدار
- تغییر مستقیم دیتابیس Production
- تغییر سیاستهای شبکه و امنیت
- افزایش سطح دسترسی کاربران یا سرویسها
- اجرای دستورهای ناشناخته روی سرورهای حساس
- Rollback یا تغییر معماری بدون بررسی وابستگیها
- تصمیمگیری درباره رخدادهای امنیتی با شواهد ناقص
در این سناریوها، باید میان تحلیل هوشمند و اجرای عملیاتی تمایز قائل شد. مدل میتواند به تصمیمگیری کمک کند، اما اقدامات پرریسک به سیاست روشن، کنترل دسترسی و معمولاً تأیید انسانی نیاز دارند.
۱۲. چالشها و محدودیتهای AI در DevOps
کیفیت و پراکندگی دادهها
اگر لاگها ساختار مشخصی نداشته باشند، Traceها ناقص باشند یا اطلاعات استقرار ثبت نشوند، تحلیل علت رخداد دشوار خواهد بود. مدل هوشمند نمیتواند بهطور قابل اعتماد اطلاعاتی را که جمعآوری نشدهاند، جایگزین کند.
توهم مدل (Hallucination)
مدل ممکن است پاسخ متقاعدکننده اما اشتباه ارائه دهد؛ برای مثال، پارامتری را پیشنهاد کند که در نسخه نصبشده وجود ندارد یا علت رخداد را بدون شواهد کافی مشخص کند. پاسخها باید با مستندات، خروجی ابزارها و آزمایش واقعی اعتبارسنجی شوند.
وابستگی بیش از حد به ابزار
اگر تیم بدون درک اصول شبکه، سیستمعامل، دیتابیس، Kubernetes و امنیت به خروجی AI اتکا کند، احتمال پذیرش خطاهای پنهان افزایش پیدا میکند. استفاده مؤثر از هوش مصنوعی به دانش مهندسی نیاز دارد، نه حذف آن.
هزینه و تأخیر
فراخوانی مدل برای هر هشدار یا هر رویداد ممکن است هزینه زیادی ایجاد کند و در زمان رخدادهای گسترده باعث افزایش تأخیر شود. بهتر است از فیلتر، نمونهگیری، Cache، مدل متناسب با وظیفه و محدودیت مصرف استفاده شود.
محرمانگی و انطباق
لاگها و فایلهای پیکربندی ممکن است شامل توکن، آدرس داخلی، اطلاعات شخصی یا جزئیات امنیتی باشند. پیش از ارسال داده به مدل باید سیاستهای طبقهبندی اطلاعات، ماسککردن دادهها و محدودیتهای دسترسی مشخص شوند.
نبود معیار سنجش روشن
صرفاً تعداد درخواستهای ارسالشده به AI یا میزان کد تولیدشده، نشاندهنده ارزش کسبوکار نیست. معیارهای واقعی باید به کیفیت تحویل نرمافزار، پایداری، امنیت، هزینه و تجربه کاربران مرتبط باشند.
۱۳. نقشه راه پیادهسازی هوش مصنوعی در DevOps
پیادهسازی موفق AI در DevOps بهتر است با یک مسئله محدود و قابل اندازهگیری آغاز شود. رویکرد «خرید یک ابزار و فعالکردن تمام قابلیتها» معمولاً ارزیابی نتیجه را دشوار میکند.
مرحله اول: شناسایی مسئله و خط مبنا
ابتدا مشخص کنید کدام فعالیت بیشترین زمان یا هزینه را مصرف میکند. برای مثال:
- زمان طولانی برای عیبیابی خطاهای Production
- تکرار شکست Pipelineها
- تعداد زیاد هشدارهای کماهمیت
- هزینه بالای بررسی دستی لاگها
- زمان زیاد برای نوشتن تست و مستندات
سپس وضعیت فعلی را با معیارهایی مانند زمان تشخیص، زمان بازیابی، نرخ شکست تغییرات و هزینه هر رخداد ثبت کنید.
مرحله دوم: آمادهسازی داده و کنترلها
قبل از افزودن لایه هوشمند، کیفیت لاگها، متریکها، Traceها، مستندات و اطلاعات تغییرات را بررسی کنید. همچنین سیاست استفاده از AI، نحوه مدیریت داده حساس، مجوزها و الزامات ممیزی را تعریف کنید.
مرحله سوم: انتخاب یک سناریوی کمریسک
برای شروع میتوان از خلاصهسازی خطاهای Pipeline، تولید پیشنویس تست یا تهیه گزارش رخداد استفاده کرد. این موارد معمولاً امکان ارزیابی خروجی را فراهم میکنند، بدون آنکه مدل مستقیماً زیرساخت Production را تغییر دهد.
مرحله چهارم: اجرای پایلوت
راهکار را روی یک تیم، یک مخزن یا یک سرویس محدود آزمایش کنید. خروجی AI را با نتیجه کارشناس مقایسه کنید و مواردی مانند پاسخ اشتباه، اطلاعات ناقص، هزینه و زمان صرفشده برای بازبینی را ثبت کنید.
مرحله پنجم: یکپارچهسازی با فرایندها
پس از اثبات ارزش پایلوت، قابلیت را در GitLab، سیستم مدیریت رخداد، داشبورد مانیتورینگ یا ابزار مستندسازی ادغام کنید. هر یکپارچهسازی باید دارای احراز هویت، محدودیت دسترسی، مدیریت خطا و ثبت رویداد باشد.
مرحله ششم: گسترش کنترلشده
پس از مشاهده نتایج پایدار، میتوان سناریوهای پیچیدهتر را بررسی کرد؛ مانند همبستهسازی هشدارها، پیشنهاد اصلاح زیرساخت یا اجرای Runbookهای محدود. گسترش دامنه دسترسی باید متناسب با شواهد و سطح ریسک انجام شود.
| بازه پیشنهادی | تمرکز | خروجی |
|---|---|---|
| هفته ۱ و ۲ | شناسایی مسئله، ثبت خط مبنا و بررسی داده | تعریف مسئله و معیار موفقیت |
| هفته ۳ و ۴ | انتخاب ابزار و اجرای نمونه اولیه | پایلوت محدود و قابل ارزیابی |
| هفته ۵ تا ۸ | ارزیابی کیفیت، امنیت و هزینه | گزارش نتایج و تصمیم برای ادامه |
| هفته ۹ تا ۱۲ | یکپارچهسازی و توسعه کنترلشده | جریان کاری پایدارتر و قابل پایش |
این بازه صرفاً یک الگوی نمونه برای برنامهریزی است. زمان واقعی به اندازه سازمان، کیفیت زیرساخت، محدودیتهای امنیتی و پیچیدگی سناریو بستگی دارد.
۱۴. چگونه ارزش و ROI هوش مصنوعی در DevOps را اندازهگیری کنیم؟
برای سنجش نتیجه باید میان صرفهجویی زمانی، بهبود کیفیت و کاهش ریسک تفاوت قائل شد. ممکن است یک ابزار زمان تولید کد را کاهش دهد، اما اگر تعداد خطاهای Production افزایش پیدا کند، نتیجه نهایی مثبت نباشد.
| شاخص | چه چیزی را اندازه میگیرد؟ | نکته ارزیابی |
|---|---|---|
| Lead Time for Changes | زمان عبور تغییر از توسعه تا تحویل | بهبود سرعت نباید باعث افت کیفیت شود. |
| Deployment Frequency | دفعات انتشار تغییرات | افزایش انتشار بهتنهایی نشانه موفقیت نیست. |
| Change Failure Rate | سهم تغییراتی که باعث اختلال یا نیاز به اصلاح میشوند | تعریف دقیق Failure باید ثابت باشد. |
| Time to Restore Service | زمان بازگرداندن سرویس پس از اختلال | برای رخدادهای مختلف باید شرایط مقایسه مشخص باشد. |
| MTTD | میانگین زمان تشخیص رخداد | باید از زمان شروع واقعی رخداد اندازهگیری شود. |
| MTTR | میانگین زمان بازیابی یا رفع رخداد، بر اساس تعریف سازمان | تعریف MTTR در گزارشها باید یکسان باشد. |
| Alert Precision | سهم هشدارهای مرتبط و قابل اقدام | کاهش تعداد هشدار نباید باعث نادیدهگرفتن مشکلات واقعی شود. |
| AI Acceptance Rate | نرخ پذیرش پیشنهادهای مدل | پذیرفتهشدن پیشنهاد لزوماً به معنی درستبودن آن نیست. |
| Cost per Incident | هزینه رسیدگی به رخداد | هزینه نیروی انسانی، ابزار و زمان اختلال را در نظر بگیرید. |
فرمول ساده محاسبه ROI
برای ارزیابی اولیه میتوان از فرمول زیر استفاده کرد:
ROI = (منافع قابل اندازهگیری − هزینه کل راهکار) ÷ هزینه کل راهکار × ۱۰۰
در این محاسبه، هزینهها فقط شامل اشتراک مدل نیستند؛ هزینه پیادهسازی، زیرساخت، نگهداری، آموزش، بازبینی خروجیها و رسیدگی به خطاهای احتمالی نیز باید لحاظ شوند.
برای مثال، اگر یک راهکار زمان جمعآوری اطلاعات رخداد را کاهش دهد، ارزش آن را میتوان با زمان صرفهجوییشده مهندسان و کاهش مدت اختلال برآورد کرد. اما برای جلوگیری از محاسبه بیش از حد منافع، باید از دوبارهشماری زمان صرفهجوییشده و هزینه کاهشیافته جلوگیری کرد.
۱۵. هوش مصنوعی چه تأثیری بر نقش مهندسان DevOps خواهد داشت؟
گسترش AI به معنی حذف خودکار نیاز به مهندسان DevOps نیست. در عوض، بخشی از فعالیتهای تکراری میتواند سریعتر انجام شود و اهمیت طراحی سیستم، استانداردسازی، امنیت، تحلیل معماری و تصمیمگیری فنی بیشتر شود.
مهندسی که بتواند خروجی مدل را ارزیابی کند، محدودیتهای آن را بشناسد، ابزارها را به شکل امن به هم متصل کند و فرایند قابل اعتماد بسازد، از هوش مصنوعی ارزش بیشتری استخراج خواهد کرد.
مهارتهای مهم در این مسیر عبارتاند از:
- درک عمیق Linux، شبکه، سیستمهای توزیعشده و Kubernetes
- تسلط بر CI/CD، GitOps و Infrastructure as Code
- آشنایی با Observability، لاگ، متریک و Distributed Tracing
- توانایی طراحی اتوماسیون قابل تکرار و قابل بازگشت
- شناخت اصول امنیت، مدیریت دسترسی و Secrets
- ارزیابی کیفیت خروجی مدلها و تشخیص خطاهای احتمالی
- طراحی جریانهای کاری هوشمند با محدودیت و نظارت مناسب
- اندازهگیری اثر فنی و اقتصادی راهکارها
از این منظر، ارزش مهندس DevOps در آینده فقط به توانایی نوشتن اسکریپت یا مدیریت سرور محدود نخواهد بود؛ توانایی طراحی و اداره یک سیستم عملیاتی قابل اعتماد اهمیت بیشتری پیدا میکند.
۱۶. آینده DevOps با AIOps، GitOps و Platform Engineering
یکی از روندهای مهم، حرکت از اتوماسیونهای منفرد به پلتفرمهایی است که ابزارها، استانداردها، دادهها و جریانهای کاری را یکپارچه میکنند.
در چنین معماریای، تیم توسعه بهجای تعامل مستقیم با دهها ابزار زیرساختی، از مسیرهای استاندارد پلتفرم برای ساخت، تست، استقرار و مشاهدهپذیری استفاده میکند. هوش مصنوعی میتواند در این پلتفرم به توضیح خطاها، پیشنهاد تغییر، جستوجوی دانش سازمانی و تسریع کارهای مهندسی کمک کند.
چند روند مهم عبارتاند از:
- AIOps: تحلیل گستردهتر دادههای عملیاتی و کاهش زمان بررسی رخدادها.
- Agentic Operations: عاملهایی که در محدوده مشخص، مراحل تشخیص و رسیدگی به مشکلات را دنبال میکنند.
- AI-assisted Security: کمک به تحلیل یافتههای امنیتی و اولویتبندی ریسک.
- Platform Engineering: ارائه قابلیتهای استاندارد و کنترلشده به تیمهای توسعه.
- Context Engineering: فراهمکردن زمینه و دادههای داخلی مناسب برای پاسخهای دقیقتر مدل.
- LLMOps: مدیریت کیفیت، هزینه، امنیت و عملکرد سرویسهای مبتنی بر مدلهای زبانی.
این روندها به معنی خودکارشدن کامل عملیات نیستند. سیستمهای حساس همچنان به مهندسی دقیق، قواعد روشن، نظارت و مدیریت ریسک نیاز خواهند داشت. تفاوت اصلی در این است که بخشی از تحلیل و هماهنگی میان ابزارها میتواند هوشمندتر و سریعتر انجام شود.
برای بررسی روندهای مرتبط، مقاله آینده DevOps و نقش هوش مصنوعی در اتوماسیون را نیز مطالعه کنید.
جمعبندی
هوش مصنوعی میتواند DevOps را در چند سطح بهبود دهد: کمک به توسعه و تولید پیکربندی، تحلیل Pipelineها، تشخیص ناهنجاری، همبستهسازی هشدارها، بررسی رخدادها، کمک به امنیت و ایجاد جریانهای کاری هوشمند.
اما موفقیت این تحول به تعداد ابزارهای AI یا میزان استفاده از مدلهای زبانی وابسته نیست. داده باکیفیت، فرایندهای استاندارد، زیرساخت قابل مشاهده، کنترل نسخه، تست خودکار، سیاستهای امنیتی و امکان ارزیابی نتیجه، پایههای اصلی استفاده مؤثر از این فناوری هستند.
بهترین نقطه شروع، انتخاب یک مسئله واقعی و قابل اندازهگیری است؛ مسئلهای که تیم برای حل آن داده کافی دارد و میتواند نتیجه را با وضعیت فعلی مقایسه کند. پس از اثبات ارزش، میتوان راهکار را بهتدریج گسترش داد و سطح اتوماسیون را متناسب با ریسک افزایش داد.
در نهایت، AI جایگزین مهندسی DevOps نیست؛ ابزاری برای تقویت یک سیستم مهندسیشده و قابل اعتماد است. سازمانهایی که ابتدا زیرساخت، فرایند و فرهنگ همکاری خود را تقویت کنند، آمادگی بیشتری برای بهرهبرداری از این فناوری خواهند داشت.
سؤالات متداول
آیا هوش مصنوعی میتواند جایگزین مهندس DevOps شود؟
خیر، نمیتوان چنین نتیجهای گرفت. AI میتواند بعضی وظایف تکراری را تسریع کند، اما طراحی معماری، ارزیابی ریسک، مسئولیتپذیری، مدیریت رخدادهای پیچیده و تصمیمگیری درباره محیط Production همچنان به دانش مهندسی و کنترل مناسب نیاز دارند.
تفاوت AIOps با مانیتورینگ معمولی چیست؟
مانیتورینگ معمولاً وضعیت متریکها و قواعد هشدار را بررسی میکند. AIOps از روشهای تحلیل داده و هوش مصنوعی برای شناسایی الگوها، تشخیص ناهنجاری، ارتباطدادن رخدادها و کمک به عیبیابی استفاده میکند. این دو رویکرد میتوانند مکمل یکدیگر باشند.
آیا برای استفاده از AI در DevOps به Kubernetes نیاز داریم؟
خیر. بسیاری از کاربردها، مانند تولید تست، تحلیل Pipeline یا خلاصهسازی لاگ، بدون Kubernetes نیز قابل استفادهاند. انتخاب زیرساخت باید بر اساس معماری و نیاز واقعی سازمان باشد.
آیا میتوان هوش مصنوعی را بهصورت Self-hosted اجرا کرد؟
بله، برخی مدلها و ابزارها امکان استقرار روی زیرساخت اختصاصی را دارند. بااینحال، انتخاب مدل باید بر اساس کیفیت، منابع سختافزاری، امنیت، مجوز استفاده، هزینه نگهداری و نیازهای واقعی سازمان انجام شود.
آیا میتوان رفع خودکار رخدادهای Production را به AI سپرد؟
در برخی سناریوهای محدود، بله؛ اما ابتدا باید فرایند تشخیص و بازیابی بهخوبی تعریف و آزمایش شده باشد. اقدامات باید محدود به مجوزهای مشخص، قابل ممیزی و در صورت امکان قابل بازگشت باشند. برای عملیات پرریسک، تأیید انسانی همچنان اهمیت دارد.
برای شروع AI در DevOps چه ابزاری مناسبتر است؟
پاسخ به مسئله بستگی دارد. برای کمک به توسعه میتوان یک دستیار کدنویسی را آزمایش کرد؛ برای تحلیل رخداد، ابتدا باید دادههای مانیتورینگ و لاگ را آماده کرد؛ و برای اتوماسیون هوشمند، لازم است ابزارها، سیاستها و سطح دسترسی مشخص شوند. شروع از یک سناریوی محدود و قابل سنجش معمولاً بهتر از استقرار همزمان چند ابزار است.
آیا AI باعث افزایش امنیت زیرساخت میشود؟
میتواند به تحلیل یافتهها و شناسایی برخی الگوهای مشکوک کمک کند، اما خودش منبع ریسکهای جدیدی نیز هست. امنیت به ترکیب ابزارهای تخصصی، کنترل دسترسی، مدیریت Secrets، بازبینی انسانی و فرایندهای قابل ممیزی وابسته است.
هوشمندسازی زیرساخت و DevOps با آلتیمیت کلاد
استفاده مؤثر از هوش مصنوعی در عملیات، با انتخاب یک مدل یا ابزار به پایان نمیرسد. برای ایجاد ارزش واقعی، باید معماری زیرساخت، فرایندهای CI/CD، Observability، امنیت، مدیریت داده و سطح اتوماسیون در کنار یکدیگر طراحی شوند.
آلتیمیت کلاد در طراحی و پیادهسازی راهکارهای زیرساختی، دواپس و پلتفرمهای عملیاتی به سازمانها کمک میکند تا زیرساختی پایدارتر، قابل مشاهدهتر و آمادهتر برای اتوماسیون هوشمند ایجاد کنند.
- پیادهسازی مانیتورینگ حرفهای
- طراحی و پیادهسازی مدیریت لاگ
- پیادهسازی CI/CD و اتوماسیون استقرار
- کانتینریزیشن و زیرساخت Kubernetes
- امنیت و هاردنینگ زیرساخت
- راهکارهای سازمانی آلتیمیت کلاد
اگر میخواهید بررسی کنید کدام بخش از فرایندهای مهندسی شما بیشترین ظرفیت را برای هوشمندسازی دارد، از طریق صفحه تماس با آلتیمیت کلاد با ما در ارتباط باشید.